
本篇 10 题|覆盖初级到高级|对话格式与训练损失。先用自己的话回答,再核对参考要点,最后练习工程追问。
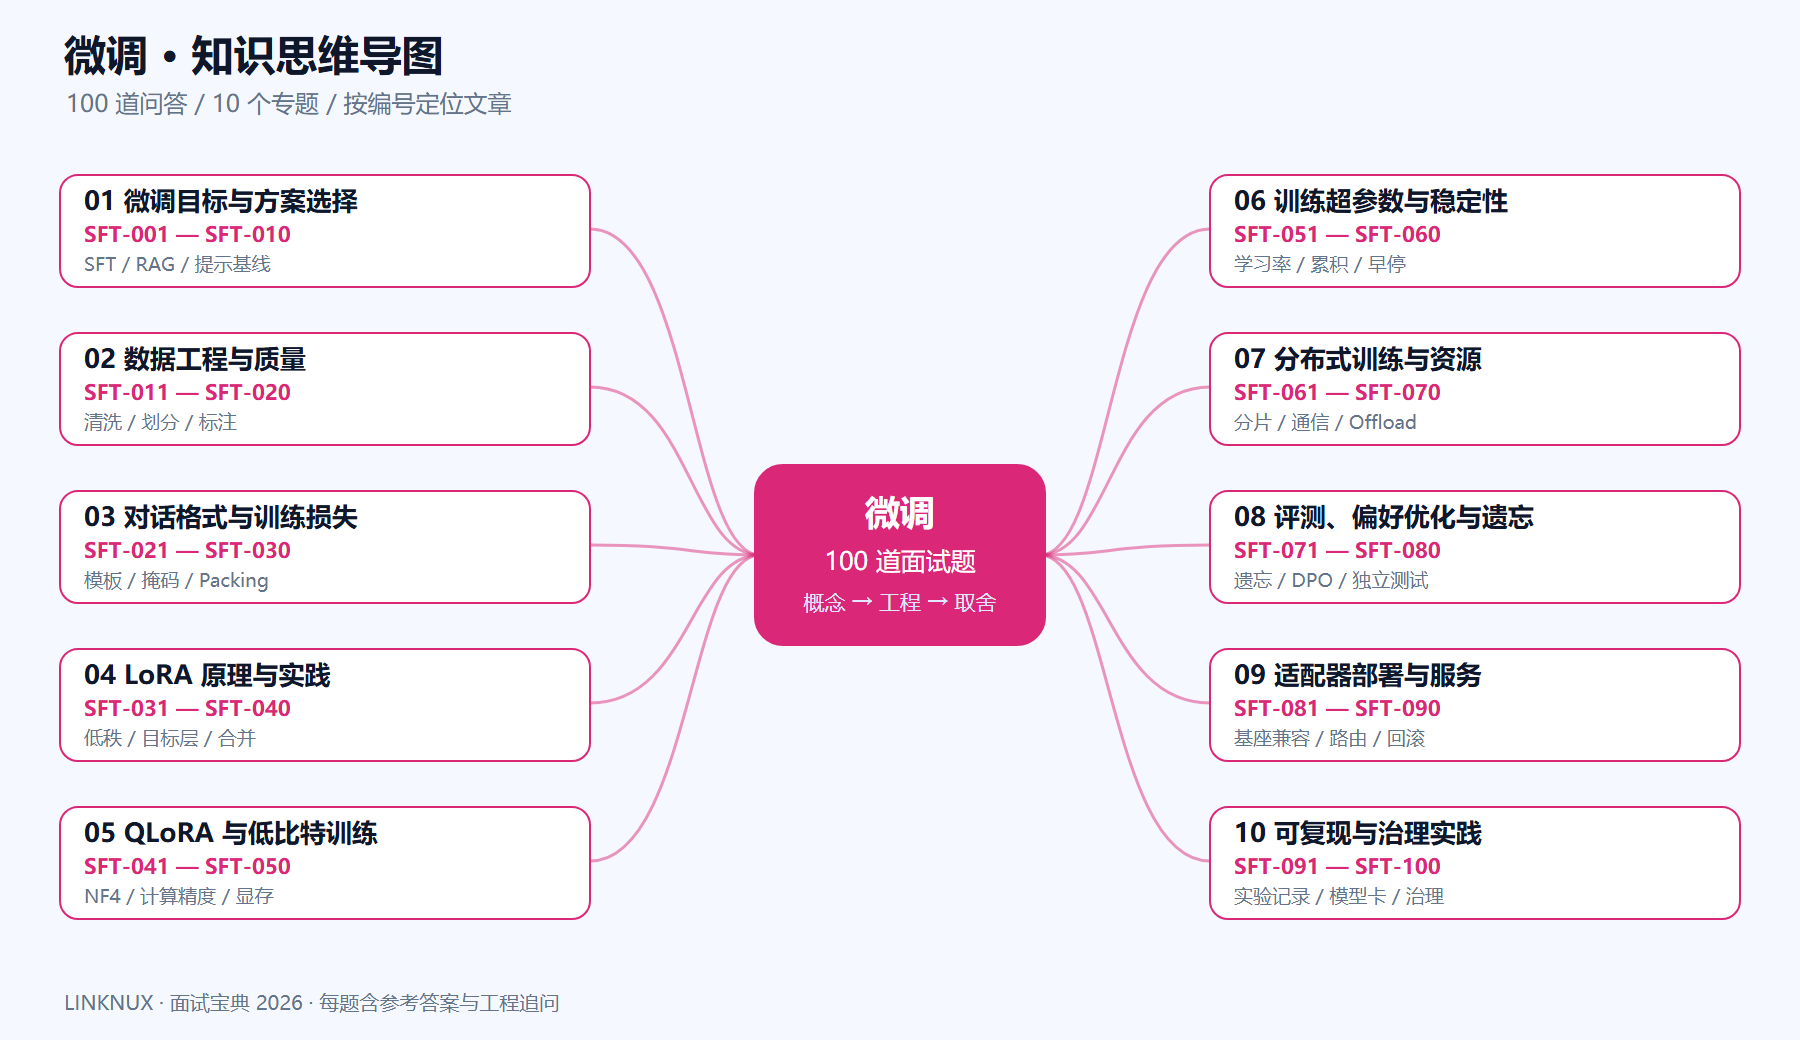
本篇目录
- SFT-021 为什么聊天模板必须一致?
- SFT-022 Tokenization 在微调中影响什么?
- SFT-023 什么是 loss mask?
- SFT-024 只训练回答与训练全部文本有何区别?
- SFT-025 序列截断有哪些隐患?
- SFT-026 样本 packing 是什么?
- SFT-027 Padding token 与结束 token 能混用吗?
- SFT-028 多轮对话数据如何整理?
- SFT-029 工具调用数据应包含什么?
- SFT-030 训练前为什么要做单批次检查?
SFT-021 为什么聊天模板必须一致?
难度:中级
参考答案:模板决定角色标记、分隔符和结束符,模型训练与推理不一致会改变输入分布。应使用基座对应模板并检查真实 token 序列。
工程追问:肉眼看到的文本一样为何 token 不同?
SFT-022 Tokenization 在微调中影响什么?
难度:中级
参考答案:影响序列长度、截断位置、特殊符号与损失对齐。使用匹配的 tokenizer 并固定版本,新增 token 时还需正确处理词嵌入和模型配置。
工程追问:词表变化后旧适配器还能直接用吗?
SFT-023 什么是 loss mask?
难度:中级
参考答案:它决定哪些 token 参与训练损失,例如只监督助手回答而忽略用户输入。必须核对任务目标与模板边界,错误掩码可能让模型学错内容。
工程追问:怎样验证真正被监督的文本?
SFT-024 只训练回答与训练全部文本有何区别?
难度:中级
参考答案:只训练回答侧重条件生成行为,全部文本也会学习输入分布。选择依赖任务与框架实现,不能假设默认设置总符合指令微调目标。
工程追问:多轮对话中监督哪些轮次?
SFT-025 序列截断有哪些隐患?
难度:中级
参考答案:可能删掉关键指令、答案末尾或结构结束符,造成错误监督。统计被截断比例并检查长样本,必要时重构样本而非简单增加最大长度。
工程追问:截断 JSON 会教会模型什么?
SFT-026 样本 packing 是什么?
难度:中级
参考答案:把多个短样本组合进较长序列以减少填充开销。需要正确设置边界、标签与注意力语义,具体行为依实现而异,必须验证是否存在跨样本干扰。
工程追问:packing 后如何追踪原始样本?
SFT-027 Padding token 与结束 token 能混用吗?
难度:中级
参考答案:某些模型配置会共享标识,但必须正确设置 attention mask 和标签掩码。不能因此把真实结束 token 全部从损失中删掉,否则影响停止行为。
工程追问:怎样验证模型学会正常结束?
SFT-028 多轮对话数据如何整理?
难度:中级
参考答案:保留角色顺序、必要历史和一致的目标回答,明确是否监督每个助手轮次。避免把不相关会话拼接成自然连续对话。
工程追问:历史中有错误答案应该保留吗?
SFT-029 工具调用数据应包含什么?
难度:中级
参考答案:包含工具名称、结构化参数、工具结果与后续回答,并符合模型对应协议。校验参数语义与权限边界,避免训练出未经授权就执行的行为。
工程追问:失败工具结果如何加入数据?
SFT-030 训练前为什么要做单批次检查?
难度:中级
参考答案:查看解码后的输入、标签、掩码和损失是否合理,可快速发现模板、截断与数据加载问题。小批次过拟合实验还能验证训练链路是否正常。
工程追问:损失不下降可能有哪些非模型原因?
复盘练习
任选一题,用“场景与约束 → 方案 → 验证方法 → 失败边界”组织一段回答。初级先讲清概念,中级补实现与测试,高级补成本、权限和故障取舍。难度标签是学习建议,同一题可继续深入。
延伸阅读
以下为本模块相关原始论文与官方文档,用于继续学习;本文为原创面试要点整理,具体框架行为以所用版本为准。