
本篇 10 题|覆盖初级到高级|评测平台项目。先用自己的话回答,再核对参考要点,最后练习工程追问。
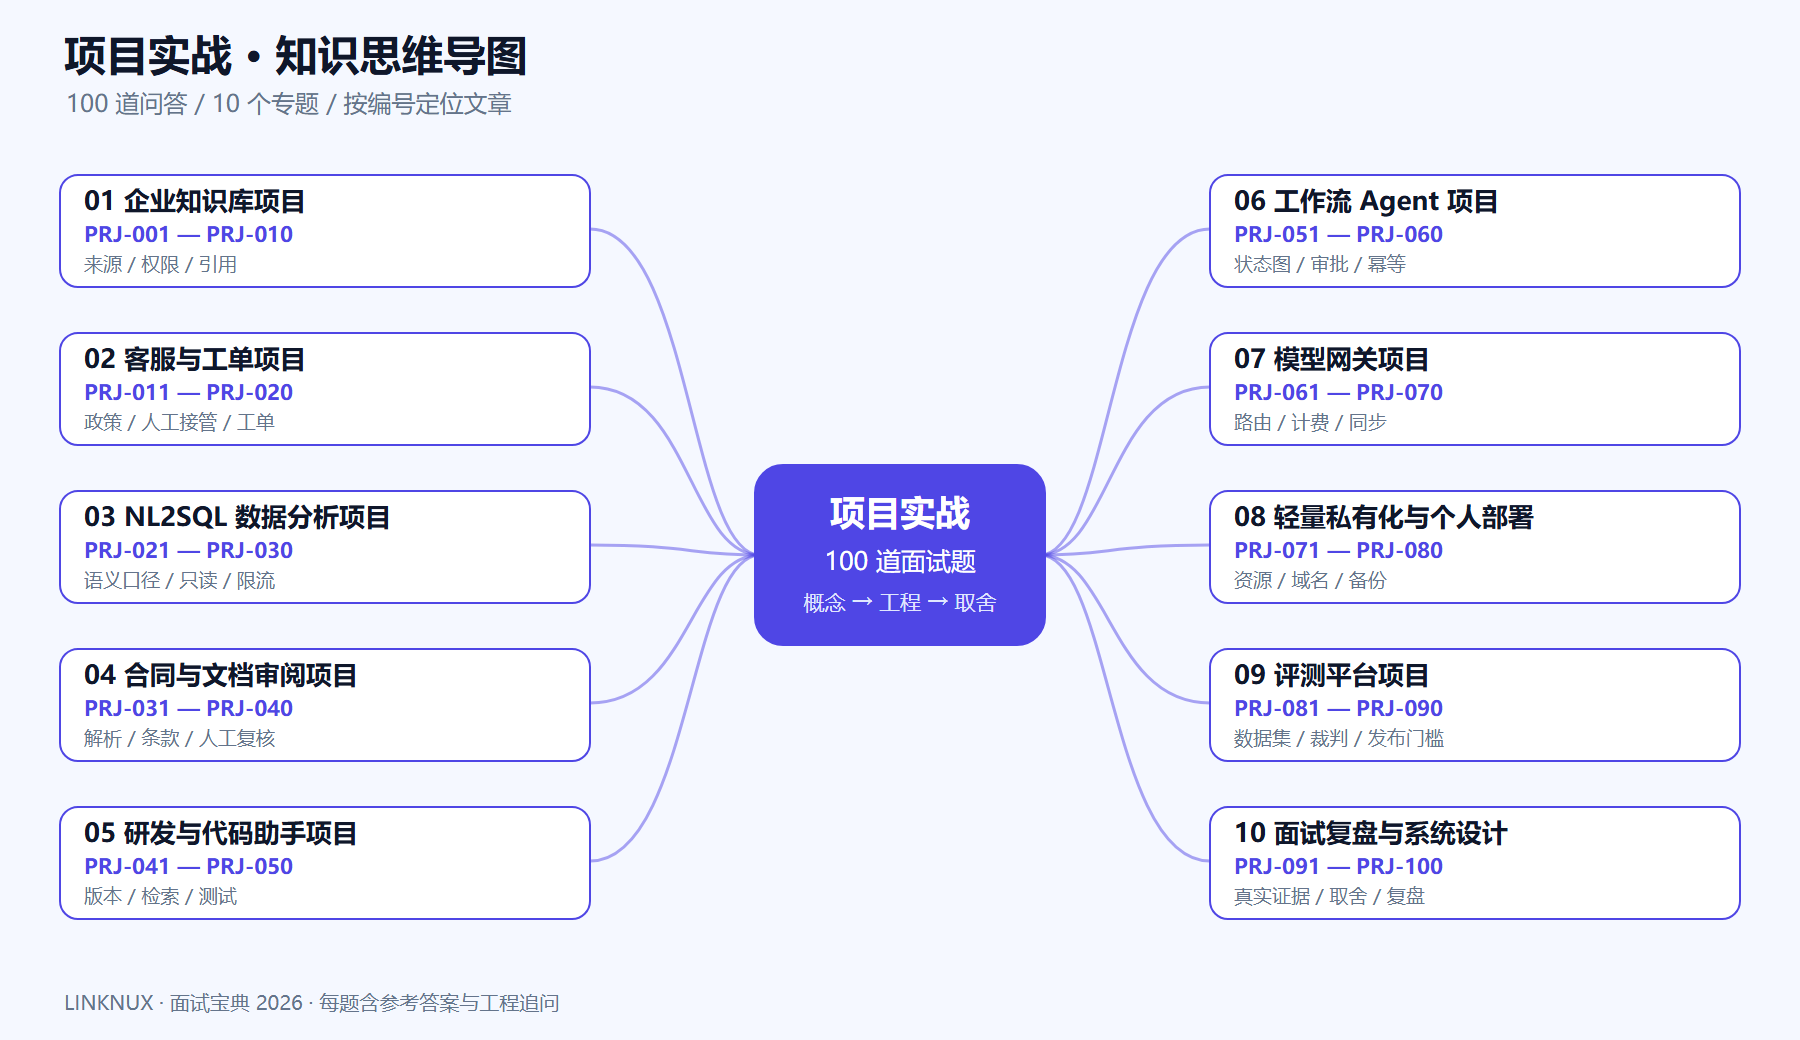
本篇目录
- PRJ-081 评测平台的最小功能是什么?
- PRJ-082 评测用例应该包含哪些字段?
- PRJ-083 如何统一评测不同模型?
- PRJ-084 模型裁判如何校准?
- PRJ-085 如何让评测结果可解释?
- PRJ-086 评测运行怎样控制成本?
- PRJ-087 如何防止数据集被反复调参污染?
- PRJ-088 评测平台如何接入发布流程?
- PRJ-089 线上反馈如何转为测试数据?
- PRJ-090 评测平台自身如何验证?
使用说明:本模块为方案设计与答题示例,不代表作者或读者已经实施这些项目。面试时请替换为自己的真实经历、测量数据和可验证证据。
PRJ-081 评测平台的最小功能是什么?
难度:高级
参考答案:管理版本化数据集、运行配置、结果与比较报告,支持确定性指标和人工复核。先保证可复现和错误定位,再考虑复杂看板。
工程追问:为什么不能只存最终总分?
PRJ-082 评测用例应该包含哪些字段?
难度:高级
参考答案:包含输入、期望行为或参考证据、任务类型、权限范围和数据版本。允许多个正确答案,敏感数据脱敏并记录来源与使用范围。
工程追问:开放问答怎样定义期望行为?
PRJ-083 如何统一评测不同模型?
难度:高级
参考答案:统一任务与计分口径,同时记录各模型实际支持特性和适配方式。合理调参但防止测试集泄漏,比较质量、成本与延迟而非单项排名。
工程追问:不同上下文上限怎样公平处理?
PRJ-084 模型裁判如何校准?
难度:高级
参考答案:用人工标注样本评估一致性与偏差,设计明确评分标准和反例。对数字、格式和权限使用确定性检查,不能完全依赖另一模型打分。
工程追问:裁判偏爱长答案如何发现?
PRJ-085 如何让评测结果可解释?
难度:高级
参考答案:提供逐用例结果、错误类型、证据与版本差异,支持按任务切片查看。让开发者知道什么变好、什么变差,而不是只有一个涨跌箭头。
工程追问:总体上升但核心场景下降怎么办?
PRJ-086 评测运行怎样控制成本?
难度:高级
参考答案:估算调用量并设置预算,按风险选择全量或抽样回归,缓存可复用的确定性产物。记录裁判调用成本,避免评测比业务本身更昂贵。
工程追问:抽样如何避免漏掉稀有高风险错误?
PRJ-087 如何防止数据集被反复调参污染?
难度:高级
参考答案:区分训练、开发和保留测试集,控制访问与使用次数,定期加入时间外样本。记录用例进入训练的情况,避免继续当作独立测试。
工程追问:公开基准高分为何不能证明业务能力?
PRJ-088 评测平台如何接入发布流程?
难度:高级
参考答案:针对变更类型选择相关用例,设置质量与安全门槛,生成可审查报告。门槛应允许人工解释异常,但不能无记录地跳过失败。
工程追问:提示词小改动需要跑哪些用例?
PRJ-089 线上反馈如何转为测试数据?
难度:高级
参考答案:经授权脱敏后复现错误,由人工确认期望结果和错误类别,再加入适当数据集。避免把用户随意评价直接当作可靠标签。
工程追问:如何防止同一事故产生大量重复用例?
PRJ-090 评测平台自身如何验证?
难度:高级
参考答案:测试指标实现、数据划分、并发执行、失败恢复和报告聚合,使用已知答案样例检查。错误的评测系统会稳定地产生误导结论,必须有独立校验。
工程追问:平均分计算错误如何影响发布决策?
复盘练习
任选一题,用“场景与约束 → 方案 → 验证方法 → 失败边界”组织一段回答。初级先讲清概念,中级补实现与测试,高级补成本、权限和故障取舍。难度标签是学习建议,同一题可继续深入。
延伸阅读
以下为本模块相关原始论文与官方文档,用于继续学习;本文为原创面试要点整理,具体框架行为以所用版本为准。