
本篇 10 题|覆盖初级到高级|Token与上下文。先用自己的话回答,再核对参考要点,最后练习工程追问。
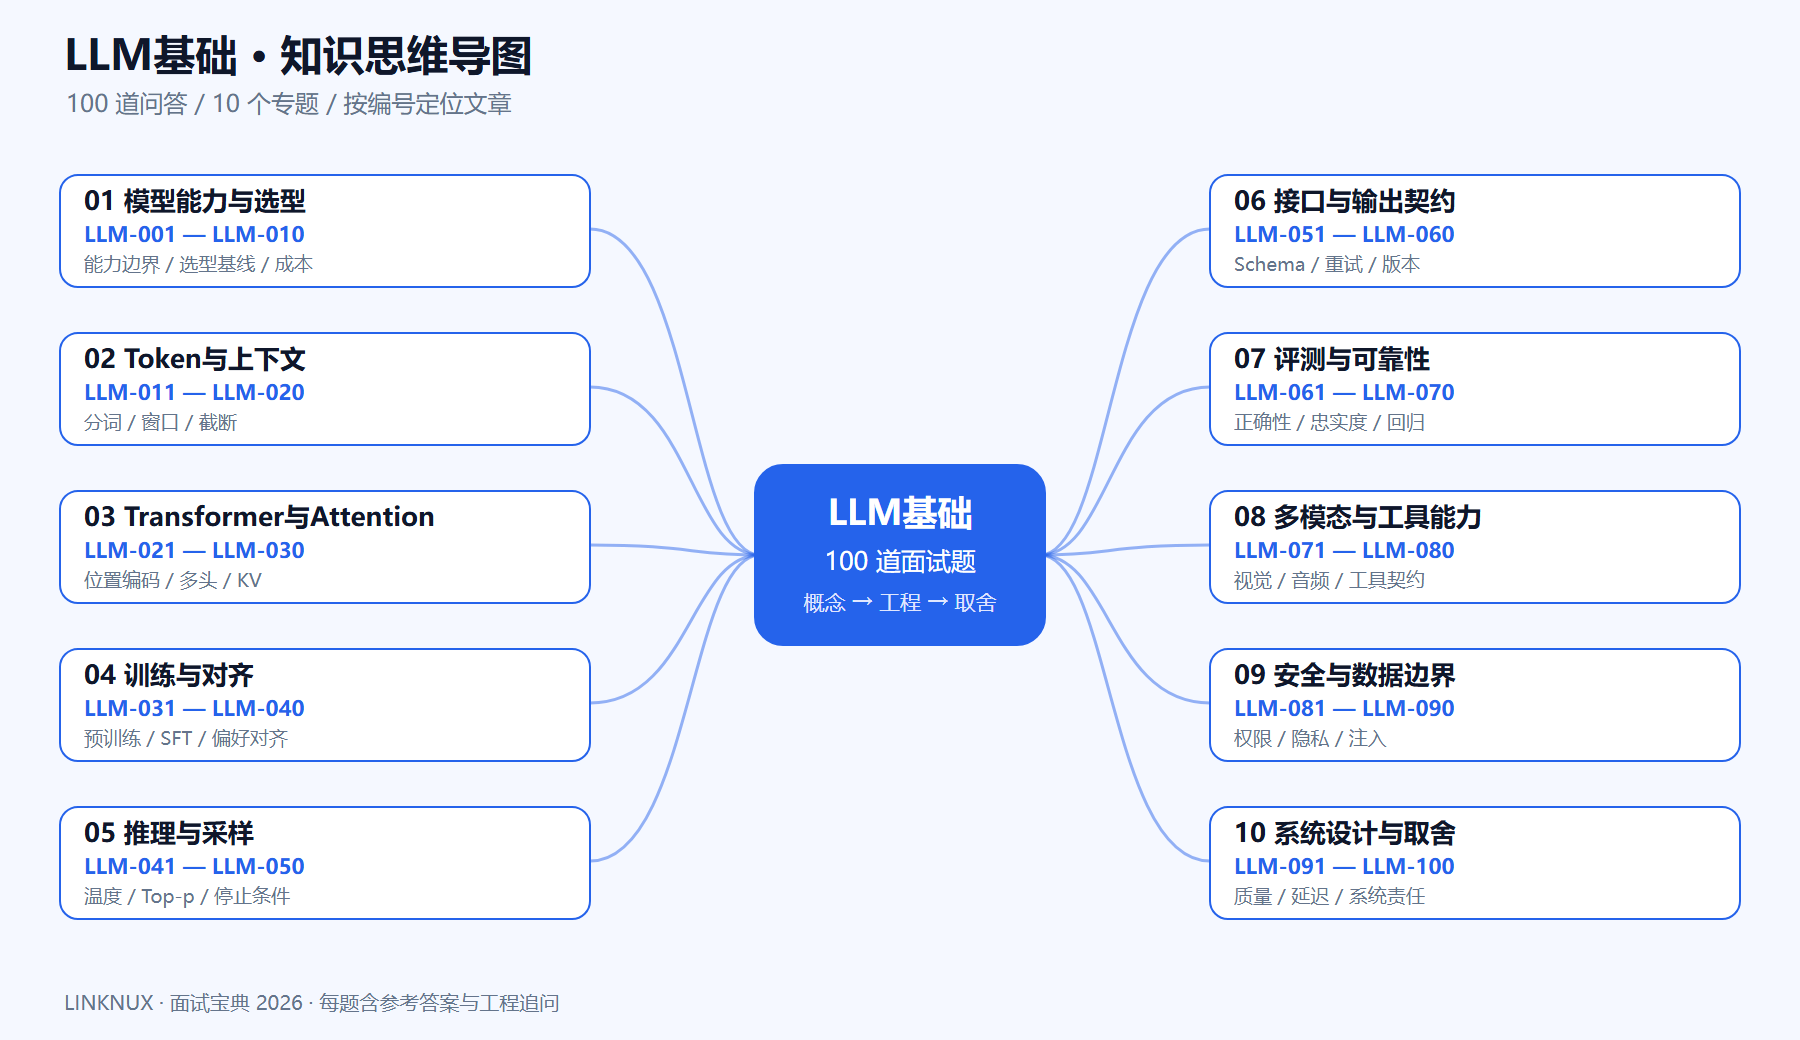
本篇目录
- LLM-011 Token 与字符、单词是什么关系?
- LLM-012 为什么模型必须配套自己的 tokenizer?
- LLM-013 上下文窗口包含哪些内容?
- LLM-014 长上下文模型能否替代检索?
- LLM-015 如何压缩多轮对话历史?
- LLM-016 滑动窗口有什么局限?
- LLM-017 为什么中文数字与日期问题容易出错?
- LLM-018 什么是上下文污染?
- LLM-019 为什么特殊结束符会影响输出?
- LLM-020 如何做跨模型上下文兼容?
LLM-011 Token 与字符、单词是什么关系?
难度:初级
参考答案:Token 是分词器定义的序列单位,可能是词、子词或字符片段。中文、代码和特殊符号的切分会因模型而异,因此预算应使用目标模型的 tokenizer 测量,不能统一按字符数折算。
工程追问:同一段文本换模型后为什么费用不同?
LLM-012 为什么模型必须配套自己的 tokenizer?
难度:初级
参考答案:词表、特殊 token 和编号映射参与模型训练。使用不匹配的 tokenizer 会改变输入语义或对话边界,即使词表大小相同也不保证兼容;部署应固定模型、tokenizer 和模板的对应版本。
工程追问:如何发现分词器与权重不匹配?
LLM-013 上下文窗口包含哪些内容?
难度:中级
参考答案:通常包含系统指令、历史对话、当前问题、工具定义和检索上下文;输出预算也受接口和模型的总长度约束。应用应分别计算输入与预留输出,超限时按明确策略裁剪,避免静默丢弃关键指令。
工程追问:工具 schema 很长会造成什么影响?
LLM-014 长上下文模型能否替代检索?
难度:初级
参考答案:不一定。窗口大只表示能够接收较长输入,不代表能准确利用每个细节。检索还能提供权限过滤、更新和成本控制;应比较长上下文直读与检索方案在目标数据上的覆盖率和引用准确性。
工程追问:如何测量长文本中部信息的利用率?
LLM-015 如何压缩多轮对话历史?
难度:中级
参考答案:将近期原文、结构化关键事实与较早摘要分层保存,优先保留用户约束、未完成任务和工具状态。摘要必须能追溯原始记录,敏感信息应按权限处理,不能让一次错误摘要永久改变用户事实。
工程追问:摘要出现错误时怎样恢复?
LLM-016 滑动窗口有什么局限?
难度:初级
参考答案:它实现简单、成本可控,但可能丢失早期约束或跨轮依赖。应把长期事实和任务状态放在结构化存储中,窗口仅承载当前交互;裁剪策略需要测试代词指代、任务续接与用户修正。
工程追问:怎样处理二十轮前给出的关键条件?
LLM-017 为什么中文数字与日期问题容易出错?
难度:初级
参考答案:分词和生成机制并不提供可靠的算术或日历约束。涉及金额、日期区间和单位换算时应调用确定性工具,并校验输入格式与时区;模型负责解释结果,不能替代业务计算。
工程追问:时间戳跨时区如何验证?
LLM-018 什么是上下文污染?
难度:初级
参考答案:无关、过时或恶意内容进入输入后,会干扰模型遵循当前目标。需要控制来源、区分指令与数据、过滤无用历史,并把访问权限放在检索或工具层执行,不能只要求模型自行判断可信度。
工程追问:检索文档中的“忽略规则”应如何处理?
LLM-019 为什么特殊结束符会影响输出?
难度:初级
参考答案:训练时的结束和角色 token 帮助模型识别消息边界。模板或停止条件不匹配,可能提前终止、继续模拟用户或重复角色标记;应使用官方模板,并分别测试自然结束与长度截断。
工程追问:如何区分正常结束和达到输出上限?
LLM-020 如何做跨模型上下文兼容?
难度:中级
参考答案:维护统一的内部消息结构,再由适配器转成各模型支持的角色、工具和多模态格式。上下文预算、系统角色和工具回传方式需按能力表处理,不能假设所有兼容接口具有相同语义。
工程追问:供应商不支持某种角色时如何降级?
复盘练习
任选一题,用“场景与约束 → 方案 → 验证方法 → 失败边界”组织一段回答。初级先讲清概念,中级补实现与测试,高级补成本、权限和故障取舍。难度标签是学习建议,同一题可继续深入。
延伸阅读
以下为本模块相关原始论文与官方文档,用于继续学习;本文为原创面试要点整理,具体框架行为以所用版本为准。