
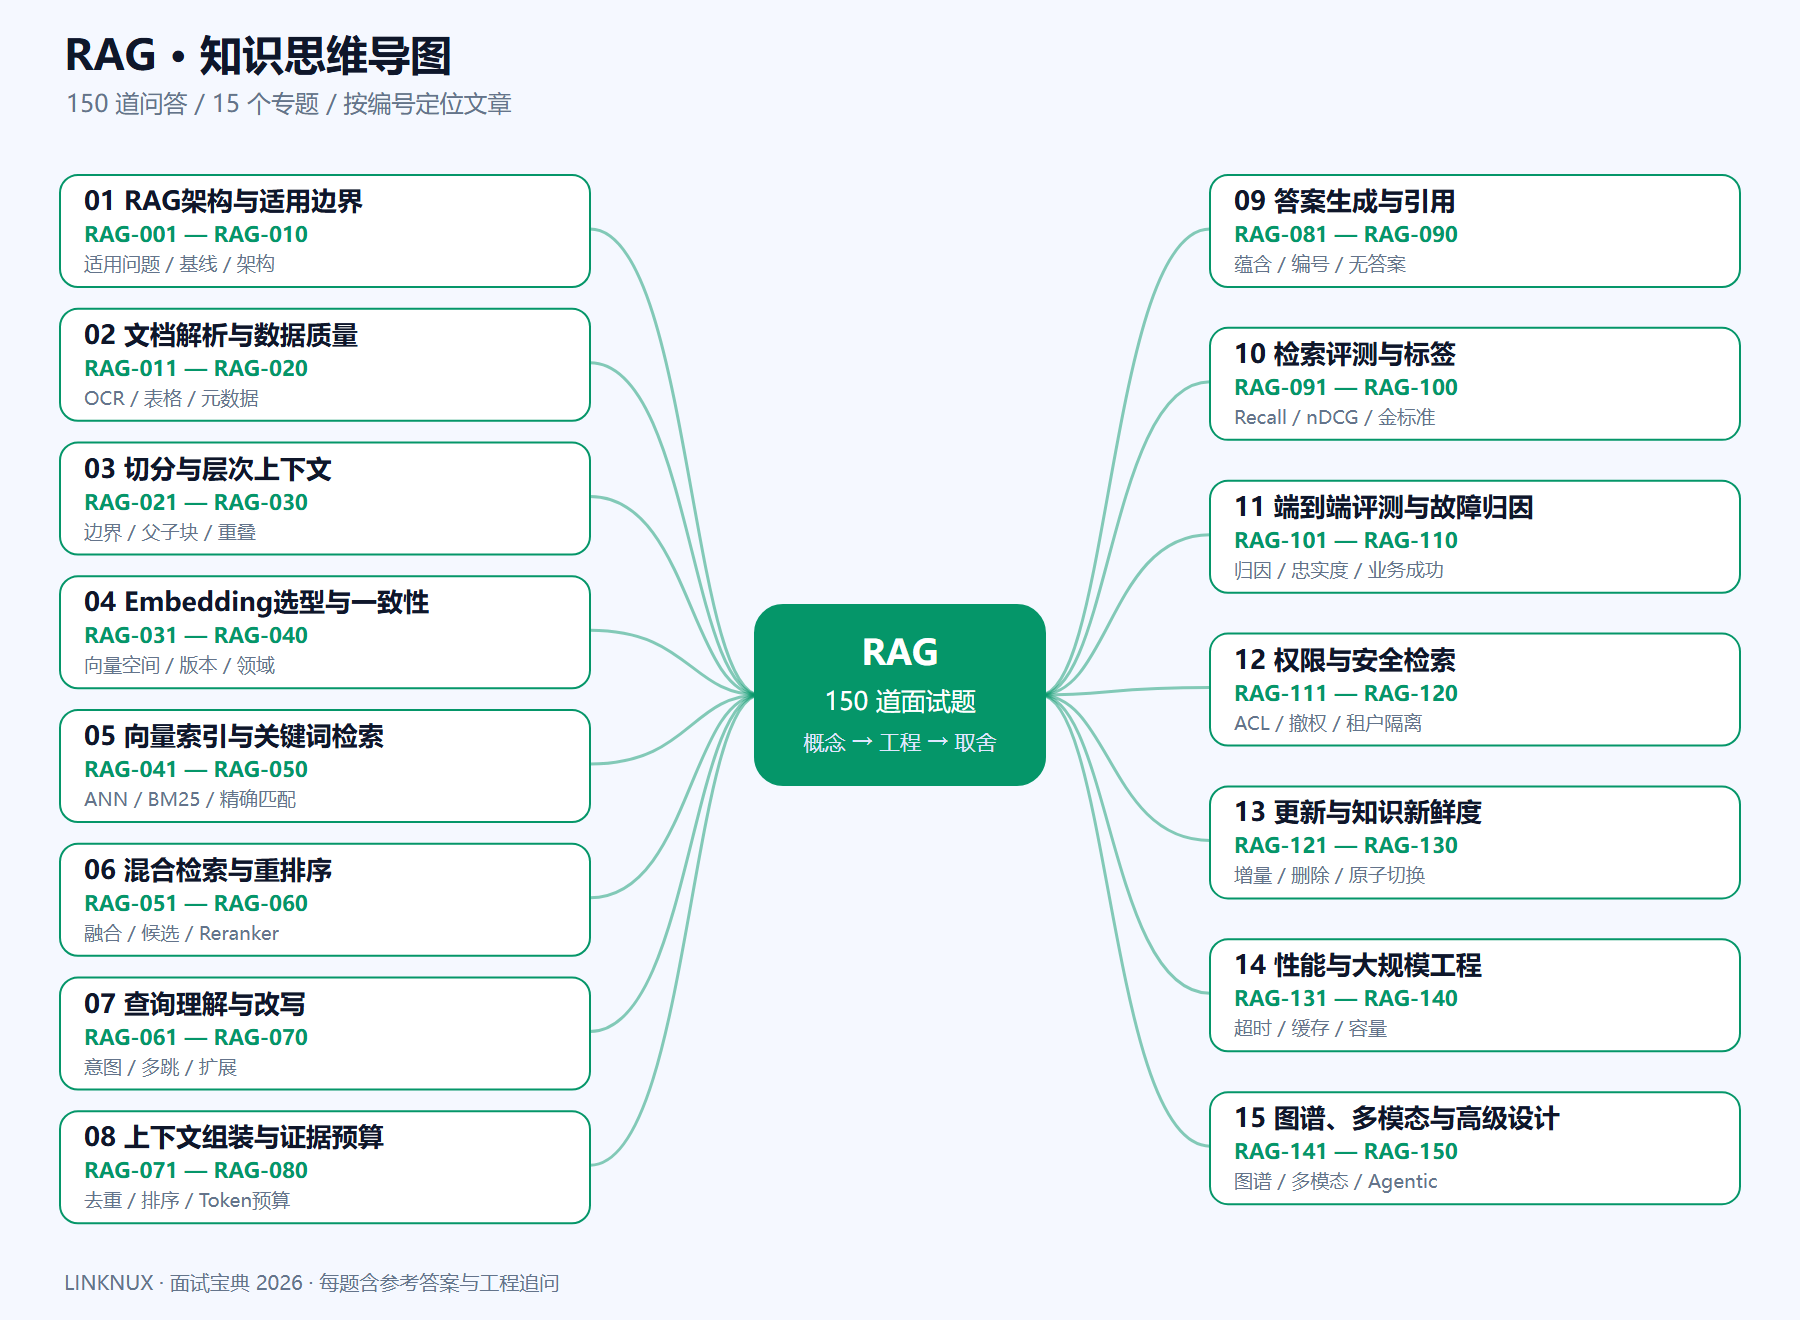
本篇 10 题|覆盖初级到高级|文档解析与数据质量。先用自己的话回答,再核对参考要点,最后练习工程追问。
本篇目录
- RAG-011 文档导入为什么要保留原始文件?
- RAG-012 PDF 解析最常见的问题是什么?
- RAG-013 扫描文档如何进入知识库?
- RAG-014 表格解析为什么要保留结构?
- RAG-015 HTML 清洗应删除哪些内容?
- RAG-016 如何处理同一文档的重复版本?
- RAG-017 为什么元数据质量与正文同样重要?
- RAG-018 怎样识别知识库里的低质量文本?
- RAG-019 如何给文档建立稳定 ID?
- RAG-020 文档导入应怎样做幂等?
RAG-011 文档导入为什么要保留原始文件?
难度:初级
参考答案:原始文件是纠错、重新解析和审计的依据。解析结果需要关联来源、哈希、版本与页码,避免格式转换后丢失证据;原始文件同样要有权限和保留策略,不能无限复制敏感资料。
工程追问:更换解析器后怎样重新构建索引?
RAG-012 PDF 解析最常见的问题是什么?
难度:初级
参考答案:阅读顺序、跨栏、页眉页脚、表格和扫描图像都可能破坏文本语义。应区分文本型与扫描型文档,做版面识别和抽样复核,不能以“提取出了字符”作为解析验收。
工程追问:双栏论文被逐行交错应如何处理?
RAG-013 扫描文档如何进入知识库?
难度:中级
参考答案:先做 OCR 与版面解析,保存文字框、页码和置信线索,再进行规范化和索引。关键数字或低置信文本要复核;OCR 错误会传播到检索与生成,后续模型不一定能修正。
工程追问:哪些 OCR 结果应进入人工审核?
RAG-014 表格解析为什么要保留结构?
难度:初级
参考答案:表格含有表头、单位和行列关系,扁平拼接会导致值归属错误。应保留行列坐标、合并单元格语义与来源页码,必要时建立结构化查询工具,而不是让模型从一串数字猜关系。
工程追问:跨页表格的表头怎样继承?
RAG-015 HTML 清洗应删除哪些内容?
难度:中级
参考答案:去除重复导航、广告和无关脚本,同时保留标题层级、正文、链接与必要表格。清洗规则应按页面类型验证,避免误删关键说明;网页中的文字仍属于低信任数据。
工程追问:一个折叠区块中的正文会不会被漏掉?
RAG-016 如何处理同一文档的重复版本?
难度:中级
参考答案:通过来源标识、内容哈希和业务版本建立关系,标记有效版本与历史版本。查询默认使用符合时间条件的版本,并明确冲突处理;单纯按文本去重可能删掉必要的修订信息。
工程追问:用户询问去年规则时应检索哪一版?
RAG-017 为什么元数据质量与正文同样重要?
难度:初级
参考答案:来源、时间、部门、权限和文档类型影响过滤与解释。错误元数据可能造成越权或使用过期证据,因此需要独立校验、默认值策略和可追溯修改记录,不能全部交给模型推断。
工程追问:缺少文档有效日期时应怎样处理?
RAG-018 怎样识别知识库里的低质量文本?
难度:中级
参考答案:检测空文本、乱码、重复页脚、异常长度和断裂表格,再抽查语义完整性。用解析质量指标和在线失败案例共同改进,避免只通过字符数阈值;短文本也可能是关键规则。
工程追问:如何确认清洗没有损害检索效果?
RAG-019 如何给文档建立稳定 ID?
难度:中级
参考答案:把逻辑文档 ID、内容版本和片段 ID 分开,使用来源系统键或受控生成规则。路径和文件名可能变化,不能作为唯一身份;稳定 ID 支持更新、删除、引用和跨系统排查。
工程追问:文件重命名后如何避免生成重复知识?
RAG-020 文档导入应怎样做幂等?
难度:高级
参考答案:同一来源版本重复提交时复用处理结果或安全更新,任务记录需区分成功、部分失败与待重试。索引写入采用稳定片段 ID,避免重试产生重复向量;导入完成前不能把半成品当成可用版本。
工程追问:导入中途断电后从哪里恢复?
复盘练习
任选一题,用“场景与约束 → 方案 → 验证方法 → 失败边界”组织一段回答。初级先讲清概念,中级补实现与测试,高级补成本、权限和故障取舍。难度标签是学习建议,同一题可继续深入。
延伸阅读
以下为本模块相关原始论文与官方文档,用于继续学习;本文为原创面试要点整理,具体框架行为以所用版本为准。