
本篇 10 题|覆盖初级到高级|Embedding选型与一致性。先用自己的话回答,再核对参考要点,最后练习工程追问。
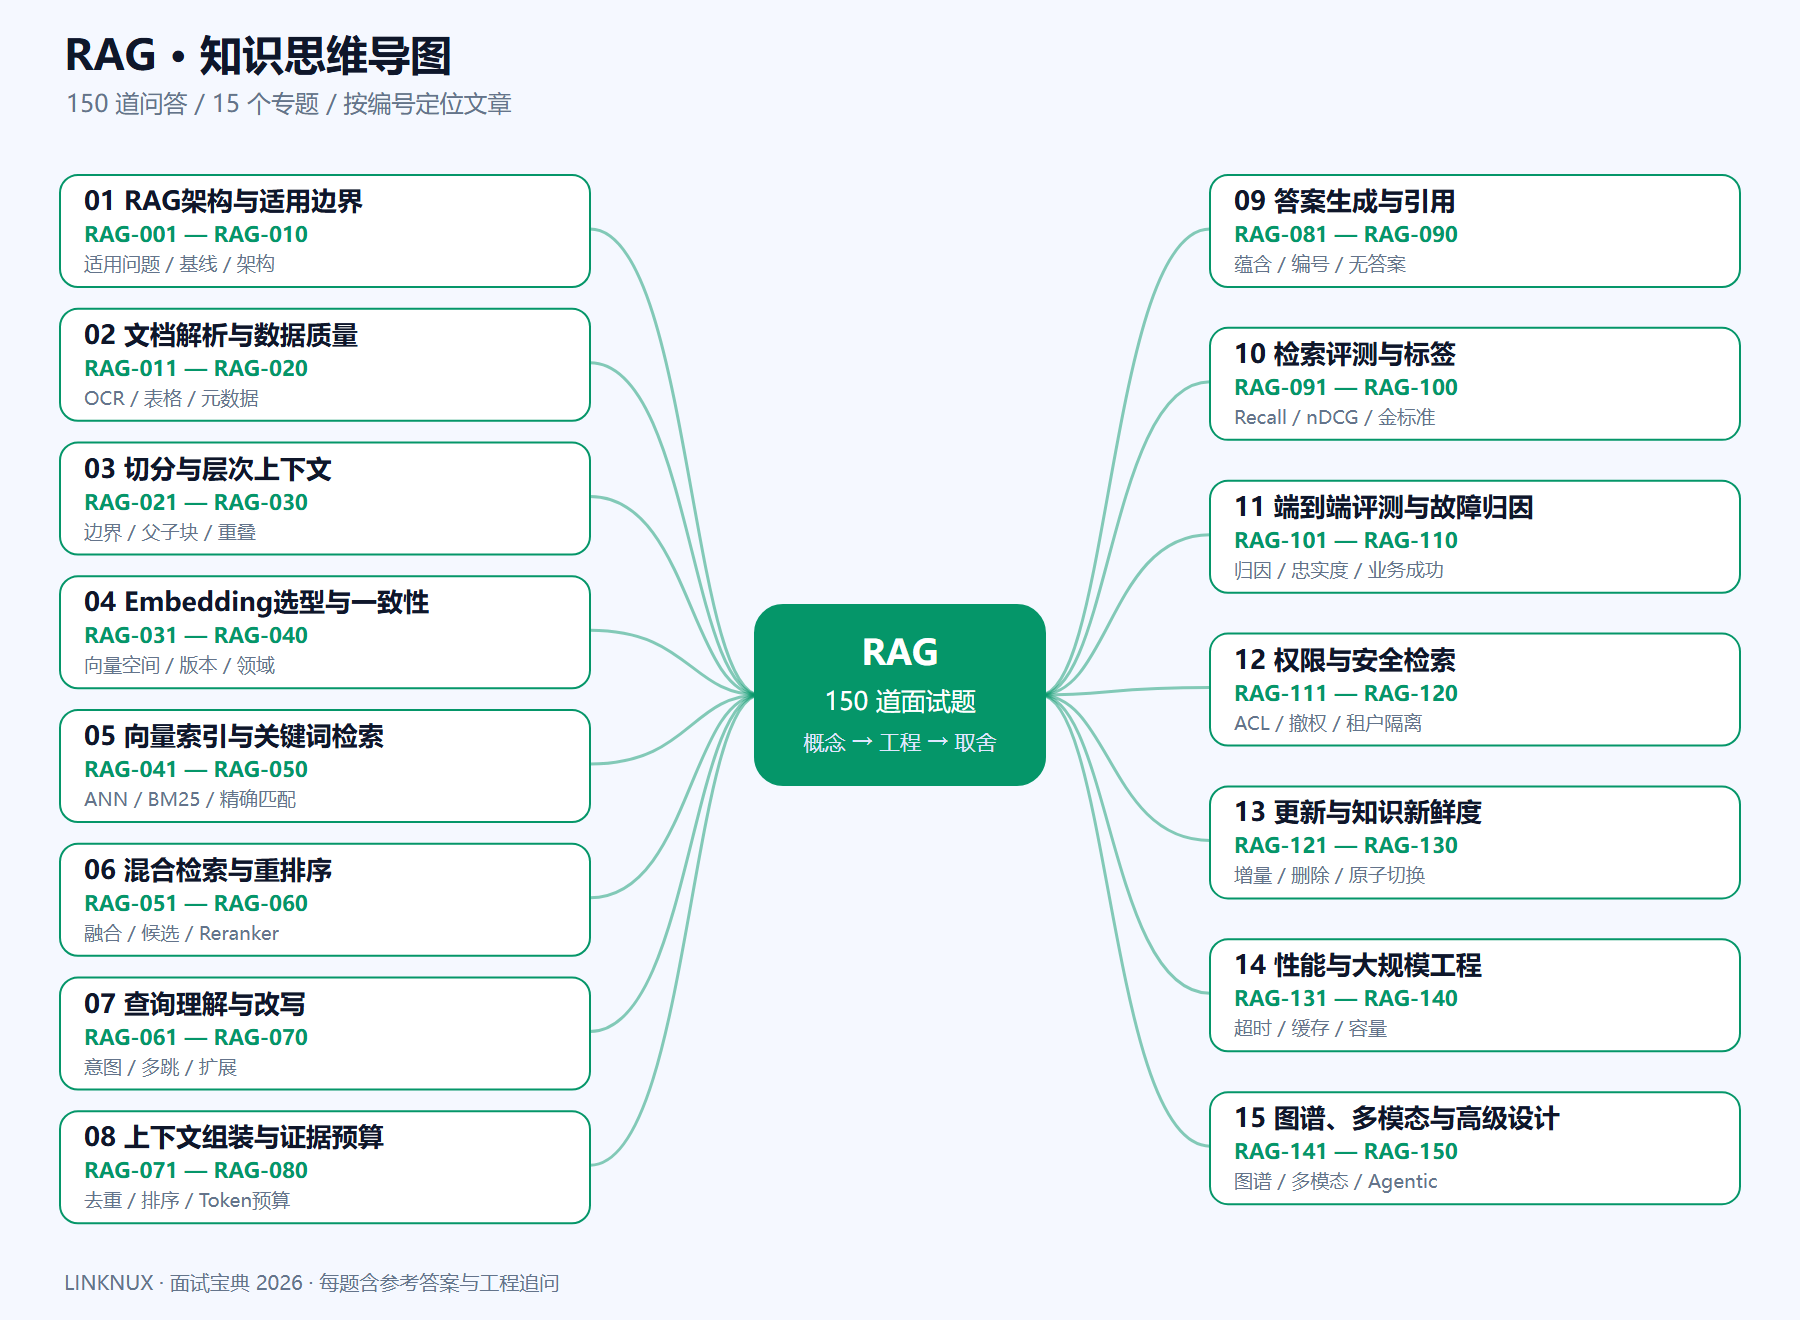
本篇目录
- RAG-031 如何选择中文 Embedding 模型?
- RAG-032 为什么查询与文档可能使用不同前缀?
- RAG-033 向量维度越大是否越好?
- RAG-034 向量归一化为什么要保持一致?
- RAG-035 能否把不同 Embedding 模型的向量混放?
- RAG-036 Embedding 模型是否也需要版本固定?
- RAG-037 长文本超过 Embedding 长度限制怎么办?
- RAG-038 如何评价 Embedding 的领域迁移能力?
- RAG-039 Embedding 缓存应该怎样设计?
- RAG-040 如何批量生成向量而不压垮服务?
RAG-031 如何选择中文 Embedding 模型?
难度:中级
参考答案:用本领域查询与文档测试召回、排序和语言覆盖,检查长度限制、输入前缀和部署成本。通用榜单可作参考,但短问句、术语和中英混合内容需要自己的评测集。
工程追问:专业缩写对检索有什么影响?
RAG-032 为什么查询与文档可能使用不同前缀?
难度:中级
参考答案:部分模型训练时区分查询和候选文本的角色,前缀或模板属于其使用约定。应遵循模型说明并保持导入与查询一致;误用前缀会造成效果变化,不能认为所有模型都需要相同处理。
工程追问:迁移模型时如何验证前缀设置?
RAG-033 向量维度越大是否越好?
难度:中级
参考答案:维度影响表示容量、存储和检索开销,但效果还取决于训练任务和数据。应在同样业务集上比较不同维度或模型,并计入索引与内存成本,不能仅以维度判断质量。
工程追问:降维后怎样评估信息损失?
RAG-034 向量归一化为什么要保持一致?
难度:中级
参考答案:余弦、点积与距离的关系依赖归一化方式。导入与查询预处理不一致,会让相似度含义发生变化;应固定归一化和度量配置,并通过已知样本核对排序。
工程追问:为什么点积可能偏好某些长文本?
RAG-035 能否把不同 Embedding 模型的向量混放?
难度:中级
参考答案:通常不能直接在同一相似度空间比较,维度相同也不代表语义对齐。迁移时应建立独立索引或明确转换方案,完成重建、回归与切换后再清理旧版本,避免混合空间造成不可解释结果。
工程追问:新模型上线时如何保持服务可用?
RAG-036 Embedding 模型是否也需要版本固定?
难度:中级
参考答案:需要。权重、tokenizer、前缀和精度变化都可能改变向量与排序。应记录完整生成配置,与索引版本绑定;查询端不能在未重建或未评测的情况下自动切换到新模型。
工程追问:一个向量究竟由哪些配置决定?
RAG-037 长文本超过 Embedding 长度限制怎么办?
难度:中级
参考答案:显式切分或选择适合长文本的模型,并验证截断方式。不能默默只编码前面内容却把片段视为完整证据;对结构复杂文档可用层次表示,保留局部检索与父块补充。
工程追问:如何监控导入中的隐式截断?
RAG-038 如何评价 Embedding 的领域迁移能力?
难度:中级
参考答案:构建含专业术语、同义表达和难负例的检索集,比较通用模型与领域适配版本。区分文档解析问题和表示问题;有提升时仍要检查跨领域泛化与更新成本。
工程追问:什么样的负例最能暴露领域差异?
RAG-039 Embedding 缓存应该怎样设计?
难度:中级
参考答案:缓存键包含规范化内容、模型版本和预处理配置,输出与索引版本关联。文档权限变化不能由向量缓存替代处理,敏感文本也需受控保存;按内容哈希缓存不等于允许跨租户共享原文。
工程追问:模型配置变化后怎样使旧缓存失效?
RAG-040 如何批量生成向量而不压垮服务?
难度:中级
参考答案:按长度和资源限制分批,控制并发与重试,记录每批的成功片段。导入任务应可恢复并采用稳定 ID,避免一个失败批次重做全部;同时观察在线查询是否被批处理抢占资源。
工程追问:如何给在线和离线任务分配资源优先级?
复盘练习
任选一题,用“场景与约束 → 方案 → 验证方法 → 失败边界”组织一段回答。初级先讲清概念,中级补实现与测试,高级补成本、权限和故障取舍。难度标签是学习建议,同一题可继续深入。
延伸阅读
以下为本模块相关原始论文与官方文档,用于继续学习;本文为原创面试要点整理,具体框架行为以所用版本为准。