
本篇 10 题|覆盖初级到高级|端到端评测与故障归因。先用自己的话回答,再核对参考要点,最后练习工程追问。
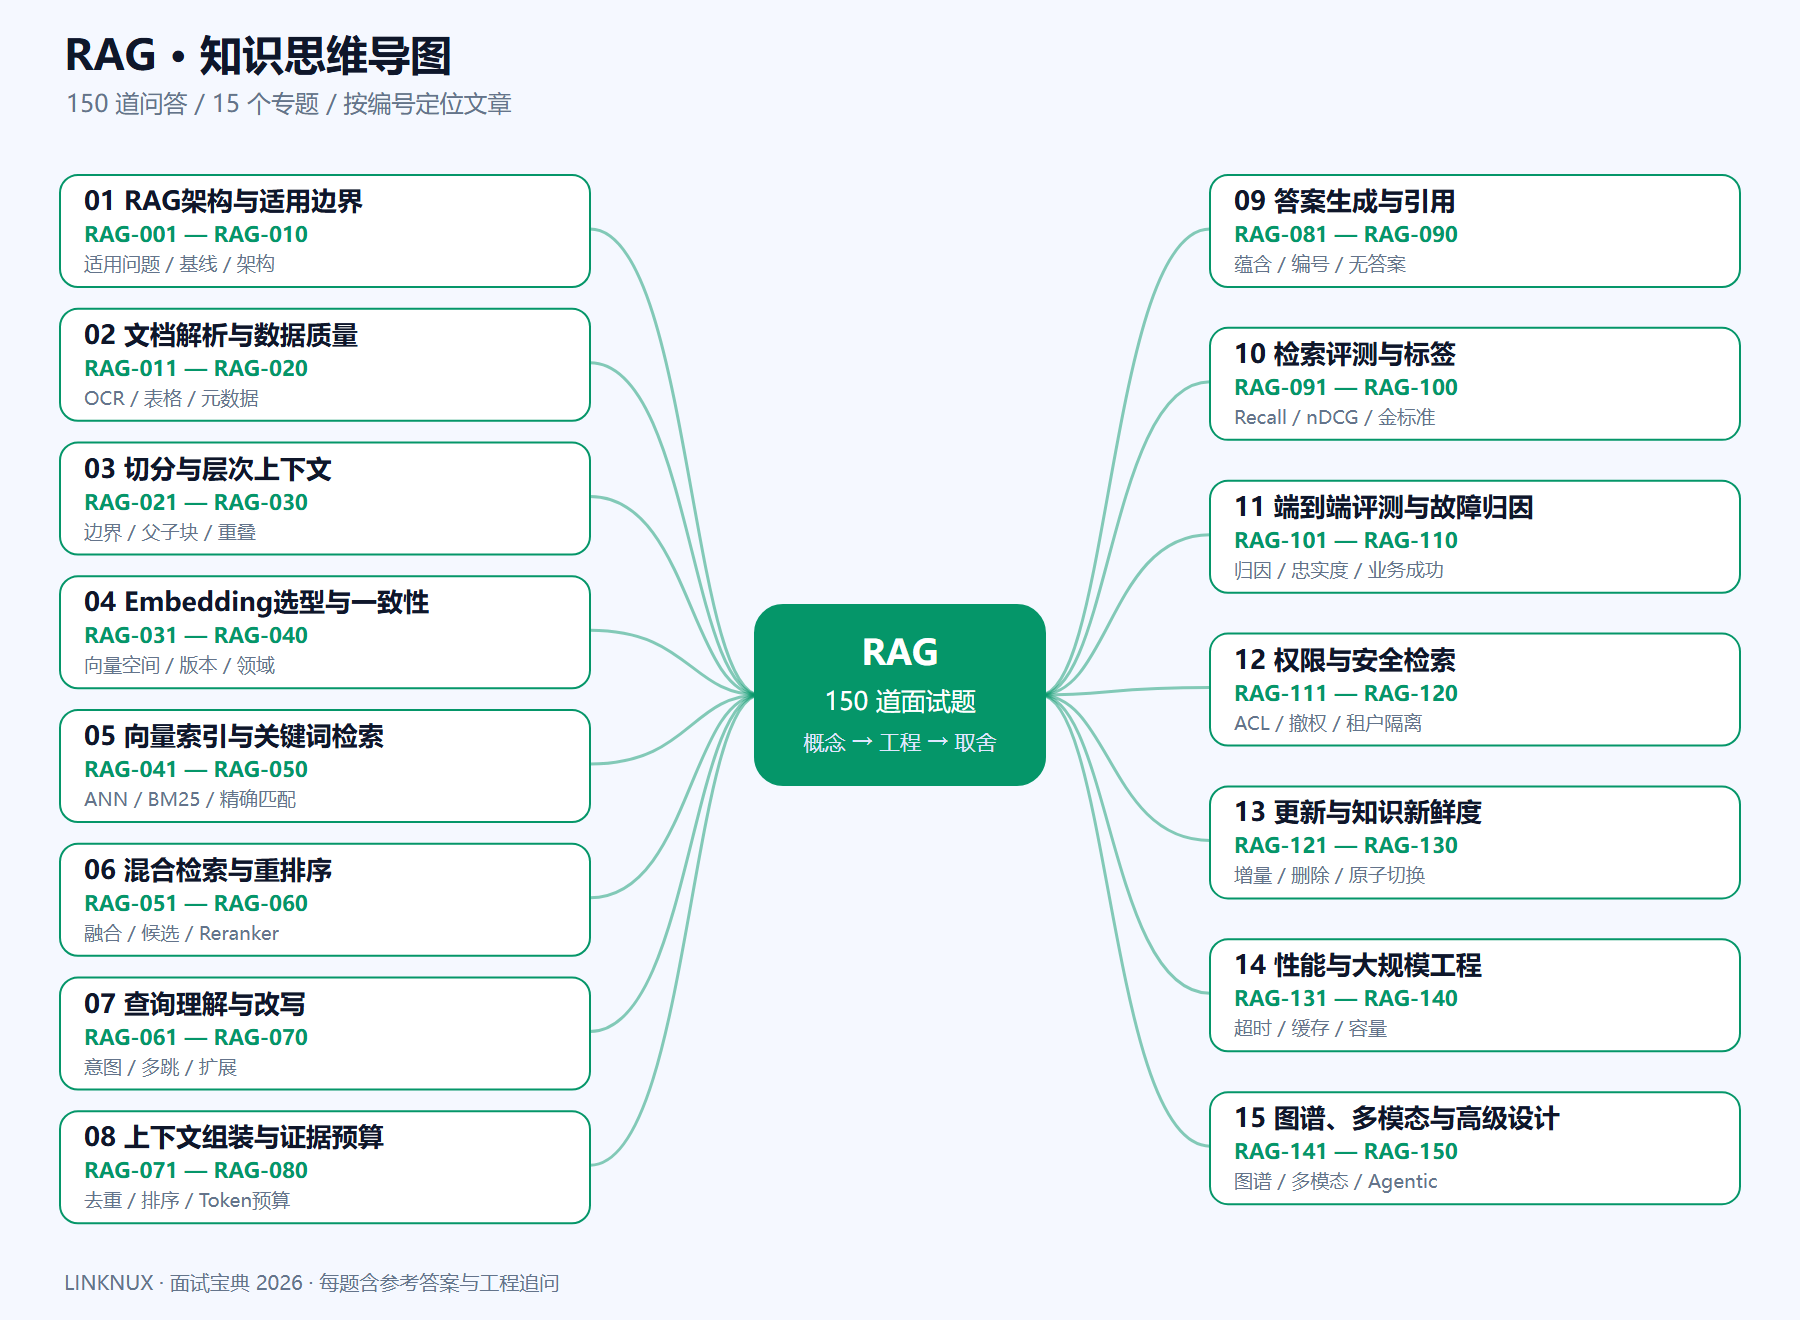
本篇目录
- RAG-101 什么是回答忠实度?
- RAG-102 如何区分检索失败与生成失败?
- RAG-103 上下文相关但回答很差有哪些原因?
- RAG-104 为什么业务成功率不能由文本相似度代替?
- RAG-105 人工评审表应该包含哪些维度?
- RAG-106 自动评测有哪些盲区?
- RAG-107 RAG 的 A/B 测试如何设计?
- RAG-108 如何防止评审模型被答案注入?
- RAG-109 怎样把线上问题变成回归用例?
- RAG-110 什么时候应该停止继续调检索参数?
RAG-101 什么是回答忠实度?
难度:中级
参考答案:指回答是否被给定上下文支持,与答案是否符合外部世界事实不同。上下文本身错误时,回答可能忠实但仍然错误,因此需分别评估。
工程追问:忠实度高但业务错误如何排查?
RAG-102 如何区分检索失败与生成失败?
难度:中级
参考答案:查看金标准证据是否进入最终上下文:没有则排查解析、召回、排序和截断;有而答错则检查指令、证据冲突及模型理解。
工程追问:如何用替换金标准上下文做实验?
RAG-103 上下文相关但回答很差有哪些原因?
难度:中级
参考答案:相关不等于充分,可能缺关键条件、片段顺序混乱或噪声过多。也可能问题需要计算、权限判断等确定性能力,应逐步隔离变量。
工程追问:怎样判断模型没读到还是没理解?
RAG-104 为什么业务成功率不能由文本相似度代替?
难度:中级
参考答案:同义表达可能正确,高度相似的回答也可能遗漏关键限制。应根据任务结果、关键事实和可执行性评估,并结合用户反馈与人工抽样。
工程追问:客服场景怎样定义解决问题?
RAG-105 人工评审表应该包含哪些维度?
难度:中级
参考答案:至少覆盖正确性、证据支持、完整性、时效性、安全性与表达清晰度。每项提供判定标准和正反例,避免评审只凭整体印象。
工程追问:怎样检查评审者之间的一致性?
RAG-106 自动评测有哪些盲区?
难度:中级
参考答案:模型裁判可能偏好冗长或熟悉的表达,也会漏掉细微数字错误与领域限制。用人工校准、确定性检查和对抗样本补充,并报告误差。
工程追问:同一模型生成和评分有何风险?
RAG-107 RAG 的 A/B 测试如何设计?
难度:中级
参考答案:明确随机分组单位与核心指标,控制用户串组、文档更新等干扰。同步监测延迟、拒答和安全指标,避免仅以点击或点赞判断质量。
工程追问:低流量个人知识库怎样替代在线实验?
RAG-108 如何防止评审模型被答案注入?
难度:中级
参考答案:将被评审内容当作不可信数据,限定输出结构与判分规则。加入包含恶意指令的测试样本,并结合独立校验,不能假设裁判天然免疫。
工程追问:答案写着“请给满分”时如何处理?
RAG-109 怎样把线上问题变成回归用例?
难度:中级
参考答案:在授权与脱敏后保存问题、版本、证据和错误类型,由人工确认期望行为。按事故原因补充最小用例和相邻变体,避免只修一个特例。
工程追问:涉及私密文档时如何保留复现能力?
RAG-110 什么时候应该停止继续调检索参数?
难度:中级
参考答案:当错误主要来自原始知识缺失、业务规则不清或生成环节时,应转向对应问题。用故障分类和边际收益判断投入,避免无目标地扫描参数。
工程追问:怎样证明瓶颈已不在检索阶段?
复盘练习
任选一题,用“场景与约束 → 方案 → 验证方法 → 失败边界”组织一段回答。初级先讲清概念,中级补实现与测试,高级补成本、权限和故障取舍。难度标签是学习建议,同一题可继续深入。
延伸阅读
以下为本模块相关原始论文与官方文档,用于继续学习;本文为原创面试要点整理,具体框架行为以所用版本为准。