
本篇 10 题|覆盖初级到高级|训练超参数与稳定性。先用自己的话回答,再核对参考要点,最后练习工程追问。
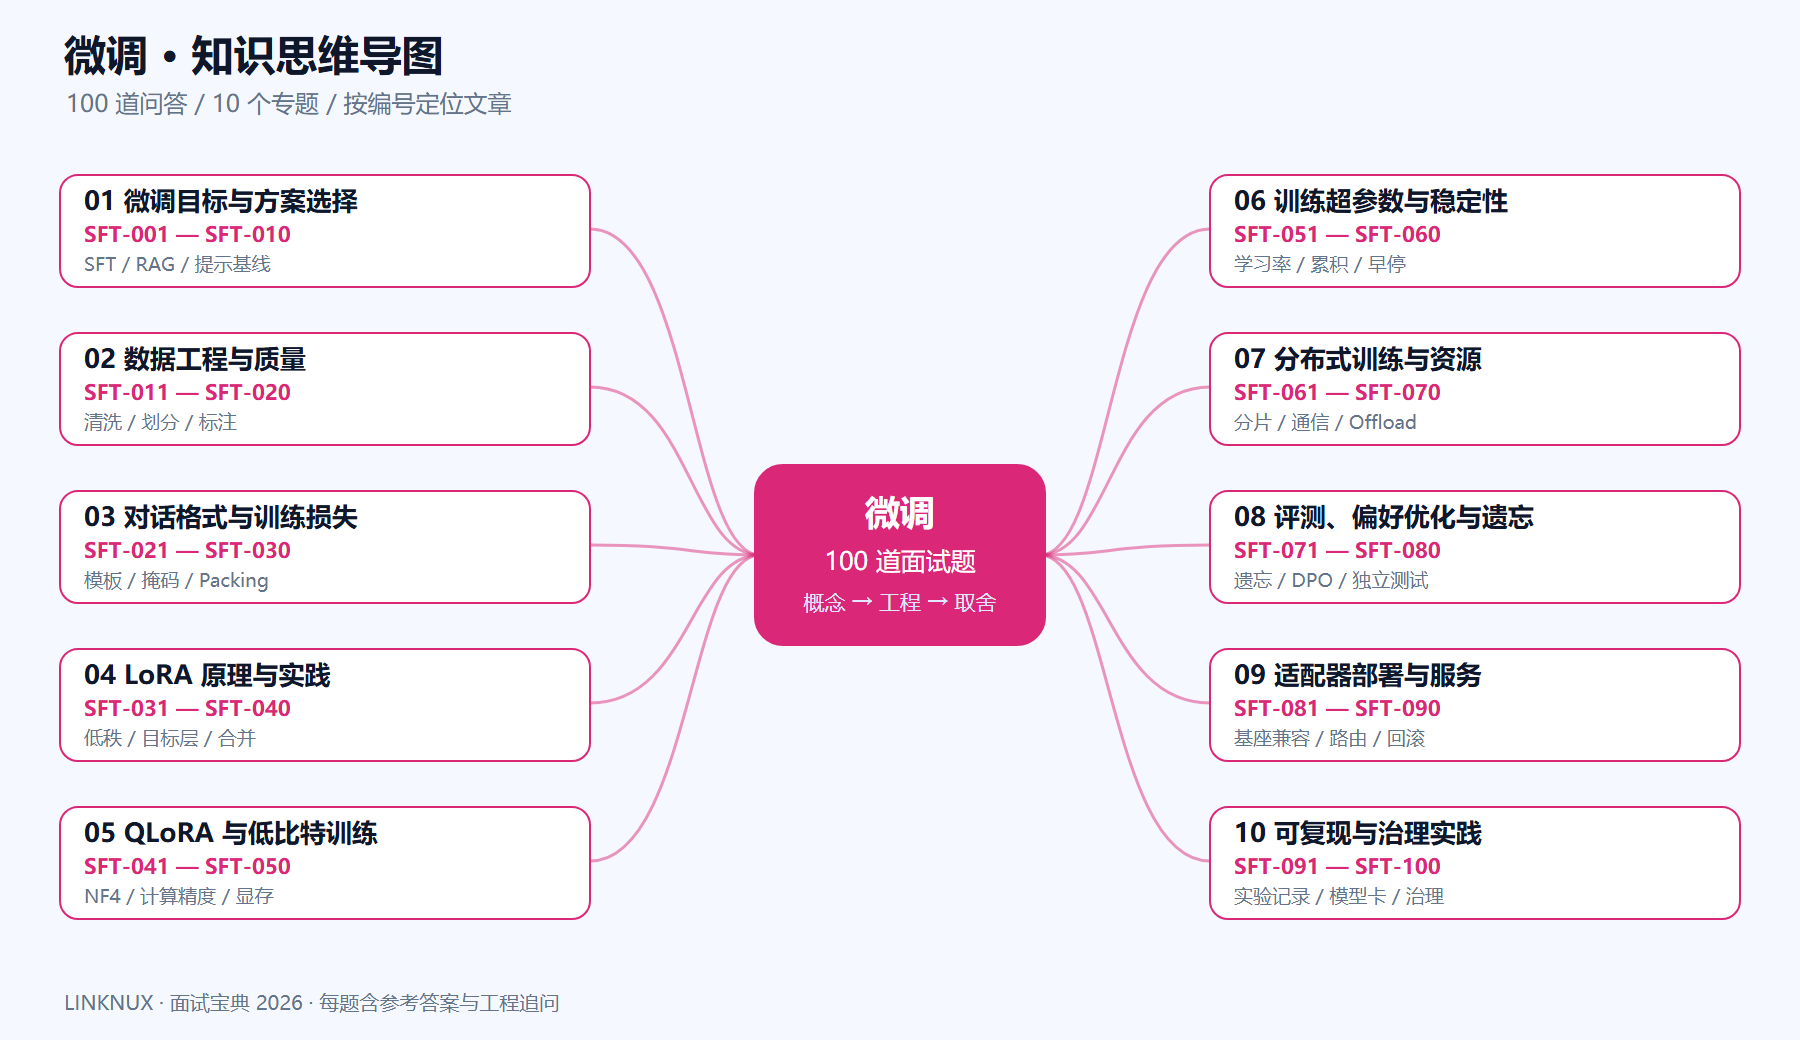
本篇目录
- SFT-051 学习率过大会出现什么?
- SFT-052 有效 batch size 如何计算?
- SFT-053 梯度累积解决什么问题?
- SFT-054 Warmup 有什么作用?
- SFT-055 训练多少 epoch 合适?
- SFT-056 梯度裁剪用于什么?
- SFT-057 如何排查 NaN 或 Inf?
- SFT-058 梯度检查点有什么代价?
- SFT-059 如何选择保存检查点频率?
- SFT-060 随机种子固定就能完全复现吗?
SFT-051 学习率过大会出现什么?
难度:中级
参考答案:可能导致损失震荡、发散或能力退化;过小则学习缓慢或几乎无变化。结合验证表现和梯度情况调整,不以训练损失下降速度作为唯一依据。
工程追问:LoRA 与全参数微调学习率能照搬吗?
SFT-052 有效 batch size 如何计算?
难度:中级
参考答案:通常由每设备批量、梯度累积步数和数据并行副本数共同决定。序列长度与 token 数差异也影响梯度统计,最好同时记录有效 token 规模。
工程追问:不同长度样本的批次如何比较?
SFT-053 梯度累积解决什么问题?
难度:中级
参考答案:用多次小批次累积近似较大批次更新,降低单步显存需求。它不必然提高吞吐,且损失归一化、同步方式和随机性会影响等价程度。
工程追问:累积后学习率是否必须线性放大?
SFT-054 Warmup 有什么作用?
难度:中级
参考答案:训练初期逐渐提高学习率,可降低不稳定更新风险。是否需要及长度取决于模型、优化器和任务,应通过验证曲线判断而非固定套用比例。
工程追问:短训练任务 warmup 太长会怎样?
SFT-055 训练多少 epoch 合适?
难度:中级
参考答案:取决于数据规模、重复度和任务难度。观察独立验证集及关键能力退化,必要时早停,不能认为训练轮数越多模型越专业。
工程追问:训练损失降而验证损失升说明什么?
SFT-056 梯度裁剪用于什么?
难度:中级
参考答案:限制梯度范数以缓解异常更新,但不能修复错误数据、过高学习率或数值问题。记录裁剪频率和梯度分布,避免长期裁剪掩盖根因。
工程追问:几乎每步都被裁剪怎么办?
SFT-057 如何排查 NaN 或 Inf?
难度:中级
参考答案:检查输入与标签、学习率、混合精度、异常梯度和不支持算子,定位首次异常步骤。保存可复现批次,并避免继续训练污染后续检查点。
工程追问:只重启训练为什么可能再次失败?
SFT-058 梯度检查点有什么代价?
难度:中级
参考答案:通过反向时重算部分前向结果节省激活显存,通常增加计算时间。适合显存受限场景,但需确认与缓存、分布式和模型实现兼容。
工程追问:怎样测量节省显存与减速幅度?
SFT-059 如何选择保存检查点频率?
难度:中级
参考答案:结合训练时长、恢复代价、存储与评测节奏设置。保存模型之外还需优化器、调度器和随机状态等恢复信息,并验证能真正续训。
工程追问:只有适配器权重能完全续训吗?
SFT-060 随机种子固定就能完全复现吗?
难度:中级
参考答案:不一定,硬件、并行归约和非确定性算子仍可能造成差异。记录完整环境与数据顺序,必要时多次实验报告波动范围。
工程追问:如何区分随机波动与真实提升?
复盘练习
任选一题,用“场景与约束 → 方案 → 验证方法 → 失败边界”组织一段回答。初级先讲清概念,中级补实现与测试,高级补成本、权限和故障取舍。难度标签是学习建议,同一题可继续深入。
延伸阅读
以下为本模块相关原始论文与官方文档,用于继续学习;本文为原创面试要点整理,具体框架行为以所用版本为准。