
本篇 10 题|覆盖初级到高级|分布式训练与资源。先用自己的话回答,再核对参考要点,最后练习工程追问。
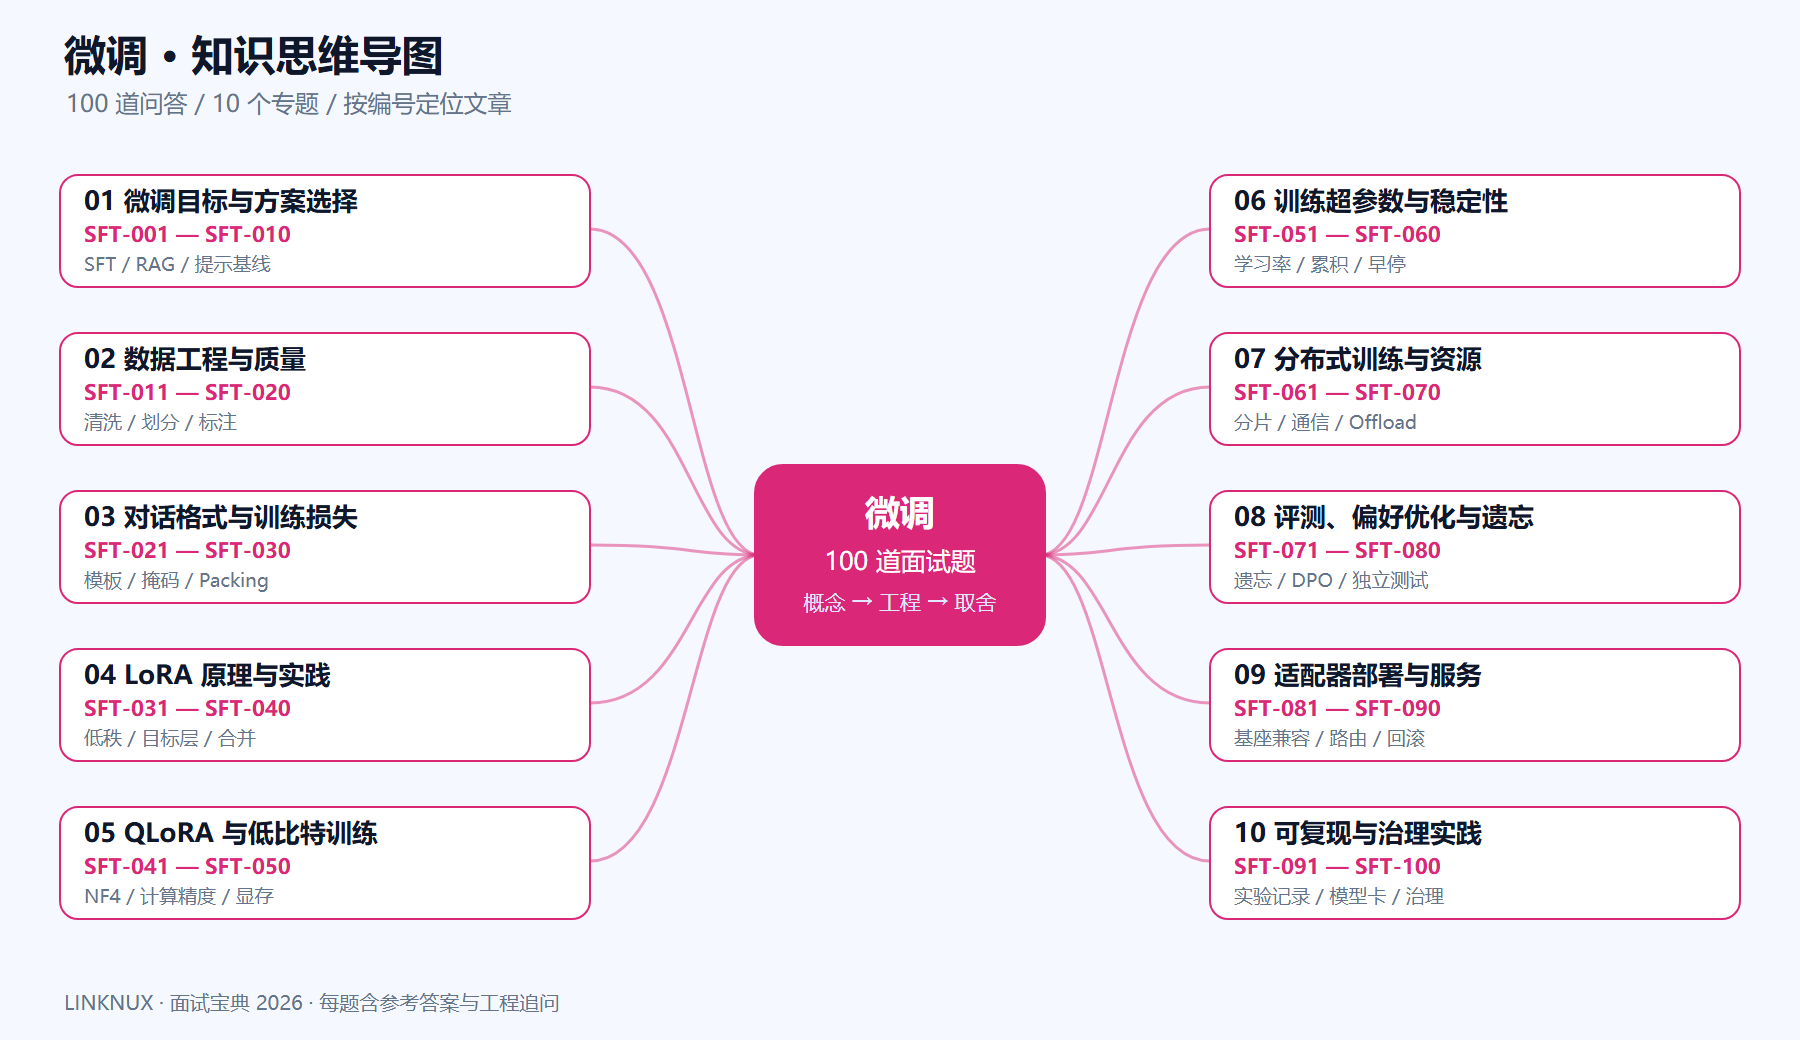
本篇目录
- SFT-061 数据并行的基本思路是什么?
- SFT-062 模型并行解决什么问题?
- SFT-063 ZeRO 的核心思想是什么?
- SFT-064 FSDP 主要做什么?
- SFT-065 CPU offload 有什么取舍?
- SFT-066 如何发现数据加载瓶颈?
- SFT-067 多卡训练如何避免数据重复?
- SFT-068 如何估算训练显存?
- SFT-069 分布式训练卡住如何排查?
- SFT-070 训练效率应该报告哪些指标?
SFT-061 数据并行的基本思路是什么?
难度:中级
参考答案:各副本处理不同数据并同步梯度,使模型获得更大吞吐。每个副本通常仍需容纳相应模型状态,通信开销可能限制扩展效率。
工程追问:增加 GPU 为什么不一定线性加速?
SFT-062 模型并行解决什么问题?
难度:中级
参考答案:将模型计算或状态分布到多个设备,以容纳更大模型或提高吞吐。张量、流水线等方案通信模式不同,应结合互联带宽和模型结构选择。
工程追问:跨机器张量并行有什么代价?
SFT-063 ZeRO 的核心思想是什么?
难度:中级
参考答案:在数据并行进程间分片优化器状态、梯度和参数等训练状态,按不同阶段降低重复存储。节省显存的同时增加通信与调度复杂度。
工程追问:为什么更高阶段不一定更快?
SFT-064 FSDP 主要做什么?
难度:中级
参考答案:通过分片模型参数、梯度与优化器状态降低每设备显存,并在计算时按需聚合。需要合理设置包装粒度与通信策略,避免频繁聚合影响吞吐。
工程追问:检查点保存如何处理分片状态?
SFT-065 CPU offload 有什么取舍?
难度:中级
参考答案:把部分状态移到主机内存可缓解 GPU 显存不足,但受 PCIe 带宽、CPU 和内存容量限制。应测量端到端吞吐,避免只看到显存下降。
工程追问:何时 offload 比缩短序列更合适?
SFT-066 如何发现数据加载瓶颈?
难度:中级
参考答案:观察 GPU 空闲间隙、数据等待时间和 CPU 或存储利用率。优化预处理、缓存和 worker 数量,同时避免过多进程争用内存与 I/O。
工程追问:预先 tokenize 有哪些收益与成本?
SFT-067 多卡训练如何避免数据重复?
难度:中级
参考答案:使用正确的分布式采样与 epoch 设置,明确补齐或丢弃尾批规则。记录样本覆盖与步数,防止每张卡都处理同一完整数据集。
工程追问:恢复训练后数据顺序如何续接?
SFT-068 如何估算训练显存?
难度:中级
参考答案:分别估算权重、梯度、优化器、激活和临时缓冲,考虑精度、序列长度、批次与分片。用小规模实测校准,因为实现细节影响峰值。
工程追问:为什么静态公式低估真实峰值?
SFT-069 分布式训练卡住如何排查?
难度:高级
参考答案:检查各进程日志、数据加载、通信超时与设备错误,确认所有 rank 是否执行相同集合通信顺序。避免只看主进程日志而忽略其他失败。
工程追问:一个 rank OOM 会造成什么现象?
SFT-070 训练效率应该报告哪些指标?
难度:中级
参考答案:报告有效 token 吞吐、设备利用率、峰值显存、通信与数据等待时间,以及达到目标质量的总成本。仅报告每步耗时会忽略不同序列和批次。
工程追问:吞吐更高但收敛更慢如何比较?
复盘练习
任选一题,用“场景与约束 → 方案 → 验证方法 → 失败边界”组织一段回答。初级先讲清概念,中级补实现与测试,高级补成本、权限和故障取舍。难度标签是学习建议,同一题可继续深入。
延伸阅读
以下为本模块相关原始论文与官方文档,用于继续学习;本文为原创面试要点整理,具体框架行为以所用版本为准。