
本篇 10 题|覆盖初级到高级|示例学习与分类抽取。先用自己的话回答,再核对参考要点,最后练习工程追问。
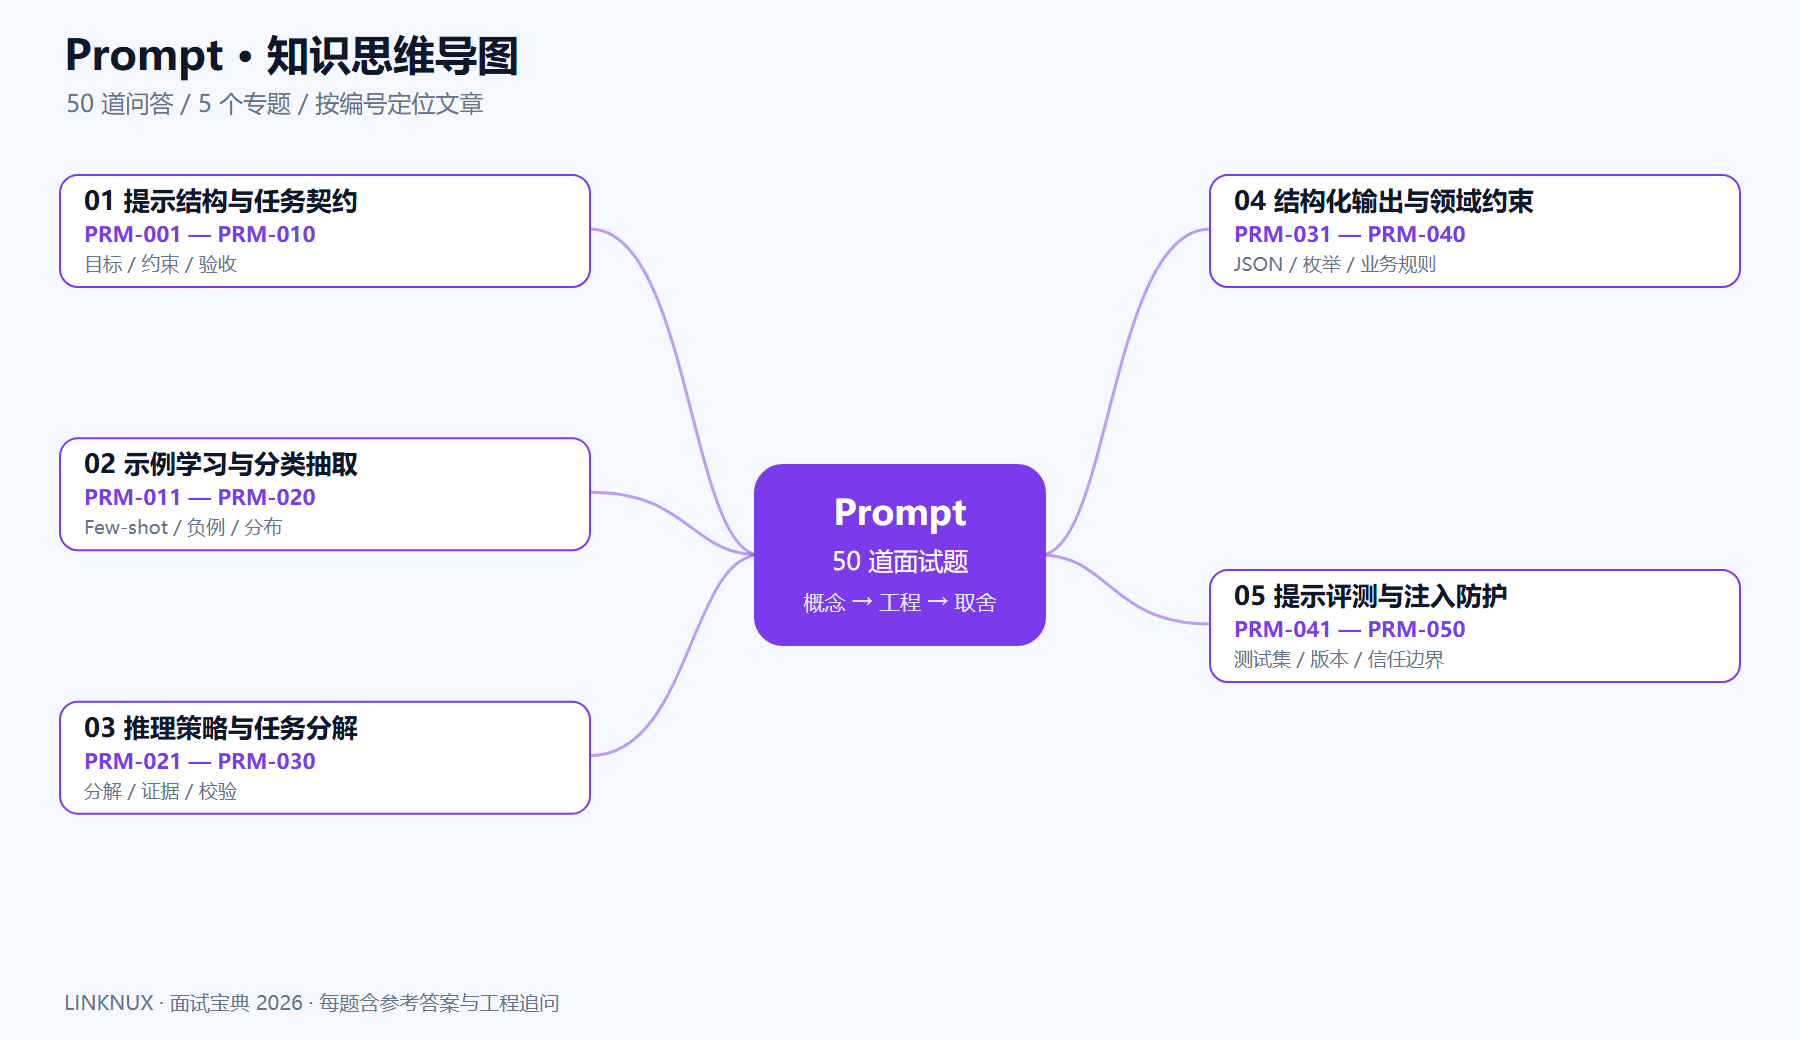
本篇目录
- PRM-011 Zero-shot 与 Few-shot 怎样选择?
- PRM-012 Few-shot 示例应该怎样挑选?
- PRM-013 为什么要加入负例?
- PRM-014 文本分类如何定义未知类别?
- PRM-015 实体抽取如何保证可追溯?
- PRM-016 如何处理多义词分类?
- PRM-017 示例包含错误答案会怎样?
- PRM-018 动态选择 Few-shot 示例如何实现?
- PRM-019 如何处理一个输入中的多个意图?
- PRM-020 如何避免抽取任务过度推断?
PRM-011 Zero-shot 与 Few-shot 怎样选择?
难度:中级
参考答案:先建立零样本基线,若规则解释不足或风格不稳定,再加入少量代表性示例。示例应覆盖关键边界和异常输入,同时控制成本;不是示例越多越好,需要验证对新样本的泛化。
工程追问:什么情况下一个反例比五个正常例子更有效?
PRM-012 Few-shot 示例应该怎样挑选?
难度:中级
参考答案:优先选择业务中常见且容易混淆的情况,保持标签和格式一致,并避免训练或测试泄漏。示例的顺序与分布可能影响输出,应该做多种排列与独立数据测试,不能只选择最简单的样本。
工程追问:类别不平衡时示例分布应如何设计?
PRM-013 为什么要加入负例?
难度:初级
参考答案:负例帮助界定哪些输入不属于目标类别或不应执行操作。需要解释合理的拒绝条件,而不是仅展示一句“不可以”;同时检查模型是否因此过度拒绝相似但合法的请求。
工程追问:如何衡量反例带来的误拒?
PRM-014 文本分类如何定义未知类别?
难度:中级
参考答案:为不符合现有标签或证据不足的输入定义明确的未知状态,并建立阈值或核验流程。不要强迫所有样本落入已知标签,否则系统会把分布外请求伪装成确定结论。
工程追问:未知类别比例上升可能说明什么?
PRM-015 实体抽取如何保证可追溯?
难度:中级
参考答案:要求输出实体、类型及对应原文片段或位置,再校验实体确实出现在输入中。规范化结果与原始值应分开,避免把模型推断的值写成文本事实,尤其是日期、编号和金额。
工程追问:抽取出的组织名称是别名时怎样保存?
PRM-016 如何处理多义词分类?
难度:中级
参考答案:在提示中补充任务范围和必要上下文,允许在信息不足时返回待确认状态。应测试跨行业、短文本和口语输入,不能用一个关键词决定类别,也不应默认模型知道用户所属业务域。
工程追问:“苹果”属于品牌还是水果如何判断?
PRM-017 示例包含错误答案会怎样?
难度:中级
参考答案:错误会变成模型模仿的局部模式,尤其影响格式、标签和边界条件。需要把示例纳入数据审核与回归测试,追踪来源和修改记录;模型偶尔纠正示例不代表可以容忍低质量样本。
工程追问:怎样发现一个示例正在持续误导分类?
PRM-018 动态选择 Few-shot 示例如何实现?
难度:中级
参考答案:可按输入任务、领域或相似度选择示例,但要防止选入泄密或与测试答案高度同源的数据。记录被选示例并与固定示例基线比较,同时控制数量和多样性,避免上下文被近重复占满。
工程追问:示例检索应采用什么权限规则?
PRM-019 如何处理一个输入中的多个意图?
难度:中级
参考答案:明确任务是主意图分类、多标签分类还是拆分任务,定义标签之间的优先级与依赖。输出应保留足够的原文依据,后端再验证可执行性;不能让模型自动发起所有识别出的操作。
工程追问:用户同时要求查询与取消订单该怎样处理?
PRM-020 如何避免抽取任务过度推断?
难度:中级
参考答案:明确只抽取显式信息,将缺失值与可推导值区分,要求推导时附规则和依据。对关键字段采用原文比对与确定性转换,防止模型为满足完整格式而补造身份证号或金额。
工程追问:“明天下午”怎样保留时间解释的前提?
复盘练习
任选一题,用“场景与约束 → 方案 → 验证方法 → 失败边界”组织一段回答。初级先讲清概念,中级补实现与测试,高级补成本、权限和故障取舍。难度标签是学习建议,同一题可继续深入。
延伸阅读
以下为本模块相关原始论文与官方文档,用于继续学习;本文为原创面试要点整理,具体框架行为以所用版本为准。