
本篇 10 题|覆盖初级到高级|推理策略与任务分解。先用自己的话回答,再核对参考要点,最后练习工程追问。
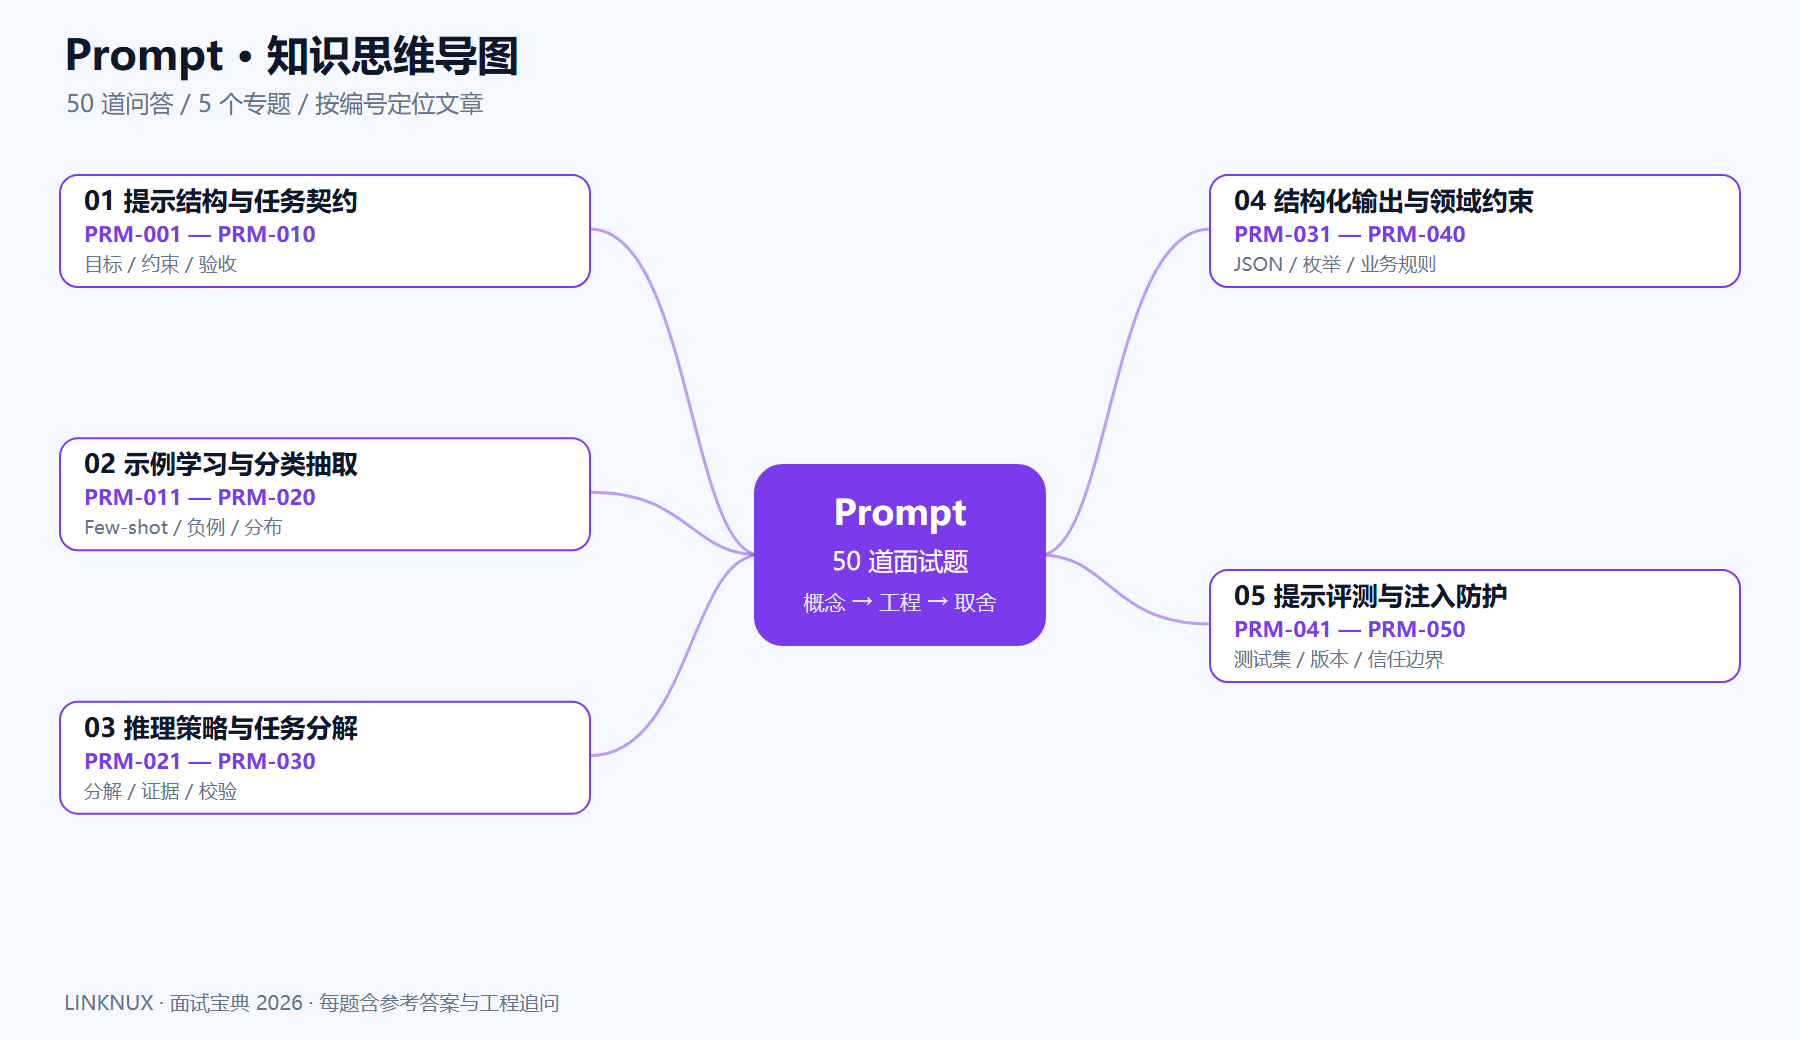
本篇目录
- PRM-021 怎样要求模型提供有用的解释?
- PRM-022 任务分解什么时候有价值?
- PRM-023 为什么“先分析再回答”不总是有效?
- PRM-024 Self-consistency 的应用思路是什么?
- PRM-025 怎样设计生成后自检?
- PRM-026 为什么生成与验证应适度分离?
- PRM-027 如何控制复杂任务的调用预算?
- PRM-028 提示链中的中间结果怎样保存?
- PRM-029 如何处理模型建议的错误计划?
- PRM-030 Prompt 分解与 Agent 的边界在哪里?
PRM-021 怎样要求模型提供有用的解释?
难度:中级
参考答案:要求简洁的结论、证据和可核实步骤,而不是把冗长推理当成质量。复杂任务可以分解并验证中间结果,但不应依赖暴露内部思维链来证明正确;验证应面向最终答案与业务约束。
工程追问:可核验解释与漂亮的解释有什么区别?
PRM-022 任务分解什么时候有价值?
难度:中级
参考答案:当任务存在不同数据源、工具或可独立验证的步骤时,分解有助于隔离错误。应定义每步输入输出和停止条件,避免无意义地增加调用次数;简单改写通常不需要多层链式调用。
工程追问:拆成五步后整体成功率如何计算?
PRM-023 为什么“先分析再回答”不总是有效?
难度:中级
参考答案:它可能改善部分任务,也可能增加长度和错误推断。应与简洁直接回答、工具计算或检索基线比较,关注正确性与成本,不能把固定提示口号视为普遍有效的优化方法。
工程追问:怎么设计验证这个提示的实验?
PRM-024 Self-consistency 的应用思路是什么?
难度:中级
参考答案:生成多个相对独立的候选,再用投票或核验选择结果。它可能降低某些随机错误,却无法消除共同的知识缺陷或偏差;需要定义可比较的答案格式并评估额外成本。
工程追问:所有候选都引用同一错误来源怎么办?
PRM-025 怎样设计生成后自检?
难度:中级
参考答案:给自检阶段明确的检查表,例如来源覆盖、字段一致性和业务限制,并提供原始证据。自检模型也可能重复原错误,重要条件应使用程序或独立评审验证,不能把“已检查”作为成功证明。
工程追问:哪些检查最好不用模型完成?
PRM-026 为什么生成与验证应适度分离?
难度:中级
参考答案:分离可以让验证器使用明确标准、不同信息或独立工具,减少对生成文本的盲目接受。验证不一定要换更大的模型,规则、数据库和人工抽检往往更可靠;独立性需要实际设计。
工程追问:同一个模型自评有哪些局限?
PRM-027 如何控制复杂任务的调用预算?
难度:中级
参考答案:按步骤设置最大调用次数、时间和成本,并记录每次调用的必要性。达到预算时应返回已完成部分或转人工,不能继续无限搜索;预算也要覆盖重试与多候选验证。
工程追问:预算耗尽后应该输出什么?
PRM-028 提示链中的中间结果怎样保存?
难度:中级
参考答案:使用结构化、可版本化的状态,记录来源、校验状态和依赖关系,避免仅存一串自由文本。对错误和缺失字段显式建模,恢复时检查中间结果是否仍有效,不能把旧缓存当成当前事实。
工程追问:修改第一步输入后哪些后续步骤需要重算?
PRM-029 如何处理模型建议的错误计划?
难度:中级
参考答案:应用检查计划的可执行性、权限、依赖和预算,将不符合条件的步骤拒绝或要求重规划。不能让模型自己批准自己的危险操作;高风险任务应有人工确认或确定性工作流。
工程追问:计划中的资源 ID 不存在时怎样反馈?
PRM-030 Prompt 分解与 Agent 的边界在哪里?
难度:中级
参考答案:固定、可预期的提示链更像工作流,Agent 会根据运行时反馈选择后续行动。是否使用自主决策要由任务变化和风险决定,不能因为流程里调用了多次模型就称其为可靠 Agent。
工程追问:哪些任务更适合固定链而非自主循环?
复盘练习
任选一题,用“场景与约束 → 方案 → 验证方法 → 失败边界”组织一段回答。初级先讲清概念,中级补实现与测试,高级补成本、权限和故障取舍。难度标签是学习建议,同一题可继续深入。
延伸阅读
以下为本模块相关原始论文与官方文档,用于继续学习;本文为原创面试要点整理,具体框架行为以所用版本为准。