
理解模型、Token、上下文、推理、评测与应用边界。 共 100 题,分为 10 篇,每篇 10 题。
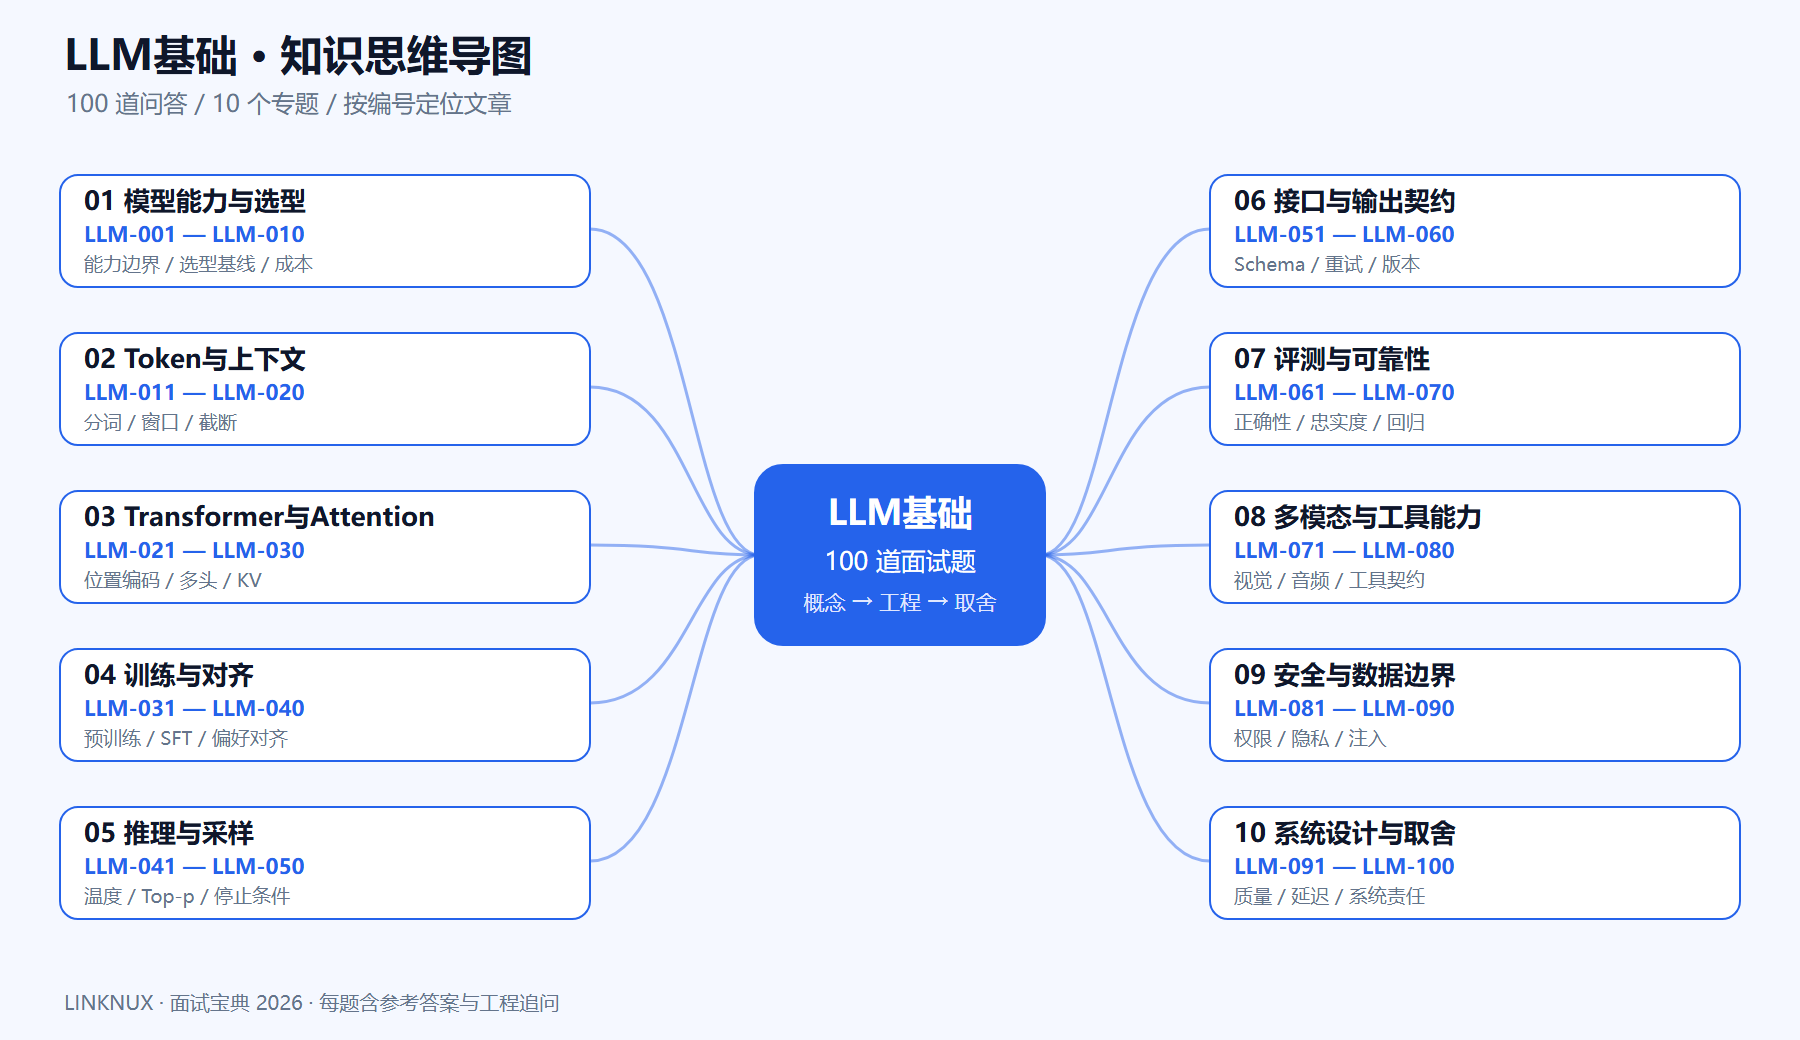
专题目录
- 模型能力与选型(LLM-001—LLM-010)
- Token与上下文(LLM-011—LLM-020)
- Transformer与Attention(LLM-021—LLM-030)
- 训练与对齐(LLM-031—LLM-040)
- 推理与采样(LLM-041—LLM-050)
- 接口与输出契约(LLM-051—LLM-060)
- 评测与可靠性(LLM-061—LLM-070)
- 多模态与工具能力(LLM-071—LLM-080)
- 安全与数据边界(LLM-081—LLM-090)
- 系统设计与取舍(LLM-091—LLM-100)
按问题查阅
模型能力与选型
- LLM-001 大模型应用开发岗位与模型研究岗位有什么区别? · 初级
- LLM-002 如何向业务同学解释大语言模型? · 中级
- LLM-003 模型参数量能否直接代表业务效果? · 初级
- LLM-004 基座模型与指令模型有什么区别? · 初级
- LLM-005 预训练知识与业务知识如何区分? · 中级
- LLM-006 大模型的能力边界应如何描述? · 中级
- LLM-007 什么是幻觉? · 初级
- LLM-008 开源权重模型与托管模型如何选择? · 中级
- LLM-009 如何构建多模型路由策略? · 中级
- LLM-010 什么时候不应该使用大模型? · 初级
Token与上下文
- LLM-011 Token 与字符、单词是什么关系? · 初级
- LLM-012 为什么模型必须配套自己的 tokenizer? · 初级
- LLM-013 上下文窗口包含哪些内容? · 中级
- LLM-014 长上下文模型能否替代检索? · 初级
- LLM-015 如何压缩多轮对话历史? · 中级
- LLM-016 滑动窗口有什么局限? · 初级
- LLM-017 为什么中文数字与日期问题容易出错? · 初级
- LLM-018 什么是上下文污染? · 初级
- LLM-019 为什么特殊结束符会影响输出? · 初级
- LLM-020 如何做跨模型上下文兼容? · 中级
Transformer与Attention
- LLM-021 Self-Attention 在做什么? · 中级
- LLM-022 Q、K、V 可以怎样直观解释? · 中级
- LLM-023 为什么点积注意力需要缩放? · 中级
- LLM-024 多头注意力有什么意义? · 中级
- LLM-025 位置编码解决什么问题? · 中级
- LLM-026 RoPE 的核心直觉是什么? · 中级
- LLM-027 残差连接与归一化有什么作用? · 中级
- LLM-028 FFN 与 Attention 如何分工? · 中级
- LLM-029 Encoder、Decoder 与 Encoder-Decoder 有何区别? · 中级
- LLM-030 MoE 为什么总参数大但激活参数较少? · 中级
训练与对齐
- LLM-031 自回归预训练的目标是什么? · 中级
- LLM-032 SFT 的作用是什么? · 中级
- LLM-033 RLHF 可以怎样解释? · 中级
- LLM-034 DPO 与基于奖励模型的优化有什么区别? · 中级
- LLM-035 为什么数据去重很重要? · 中级
- LLM-036 什么是灾难性遗忘? · 中级
- LLM-037 训练集、验证集、测试集如何划分? · 中级
- LLM-038 为什么格式正确的训练数据仍可能有问题? · 中级
- LLM-039 模型知识截止时间对应用意味着什么? · 中级
- LLM-040 为什么对齐后的模型也可能被诱导? · 中级
推理与采样
- LLM-041 Prefill 与 Decode 的区别是什么? · 中级
- LLM-042 temperature 会怎样影响生成? · 中级
- LLM-043 top-p 与 top-k 有何区别? · 中级
- LLM-044 贪心解码有什么优缺点? · 中级
- LLM-045 重复惩罚能解决哪些问题? · 中级
- LLM-046 max output tokens 设置过小会怎样? · 中级
- LLM-047 停止序列应该如何设计? · 中级
- LLM-048 随机种子能保证跨环境复现吗? · 中级
- LLM-049 为什么更多推理预算不一定更好? · 中级
- LLM-050 如何评价流式响应的用户体验? · 中级
接口与输出契约
- LLM-051 为什么模型 API 需要适配层? · 中级
- LLM-052 如何让模型返回可靠的 JSON? · 中级
- LLM-053 JSON Schema 能替代业务校验吗? · 中级
- LLM-054 Function Calling 是模型直接执行函数吗? · 中级
- LLM-055 如何区分文本回答与工具调用? · 中级
- LLM-056 模型 API 的错误应该怎样分类? · 中级
- LLM-057 应用为什么要记录 request ID? · 中级
- LLM-058 如何处理模型接口版本变化? · 中级
- LLM-059 工具结果应怎样交给模型? · 中级
- LLM-060 如何保证多轮消息的角色顺序? · 中级
评测与可靠性
- LLM-061 为什么不能只用通用排行榜选模型? · 中级
- LLM-062 什么是离线评测与在线评测? · 中级
- LLM-063 如何用 LLM 作为评审模型? · 中级
- LLM-064 为什么要做成对比较? · 中级
- LLM-065 正确率与用户满意度为什么不同? · 中级
- LLM-066 模型置信度是否可信? · 中级
- LLM-067 如何评测拒答能力? · 中级
- LLM-068 回归测试集如何维护? · 中级
- LLM-069 怎么报告一次模型对比实验? · 中级
- LLM-070 为什么模型更新必须做灰度? · 高级
多模态与工具能力
- LLM-071 多模态模型能否直接理解任意图片? · 中级
- LLM-072 OCR 与视觉语言模型如何协作? · 中级
- LLM-073 音频应用需要关注哪些额外问题? · 中级
- LLM-074 视频输入为什么不能只看单帧? · 中级
- LLM-075 Embedding 模型与生成模型有什么区别? · 中级
- LLM-076 模型会调用工具是否意味着适合 Agent? · 中级
- LLM-077 结构化输入为何有利于工具使用? · 中级
- LLM-078 如何评测代码生成能力? · 中级
- LLM-079 大模型与搜索引擎的关系是什么? · 中级
- LLM-080 为什么模型工具能力要单独评测? · 中级
安全与数据边界
- LLM-081 为什么不应该把 API 密钥放进提示? · 高级
- LLM-082 提示注入与普通用户指令如何区分? · 高级
- LLM-083 模型输出为什么是不可信输入? · 高级
- LLM-084 如何设计最小权限的工具代理? · 高级
- LLM-085 如何减少训练或日志中的敏感数据? · 高级
- LLM-086 内容过滤应放在哪里? · 高级
- LLM-087 如何做对抗性测试而不影响生产数据? · 高级
- LLM-088 数据删除为什么要覆盖多个存储层? · 高级
- LLM-089 如何隔离不同租户的大模型会话? · 高级
- LLM-090 安全性与可用性如何平衡? · 高级