
本篇 10 题|覆盖初级到高级|Transformer与Attention。先用自己的话回答,再核对参考要点,最后练习工程追问。
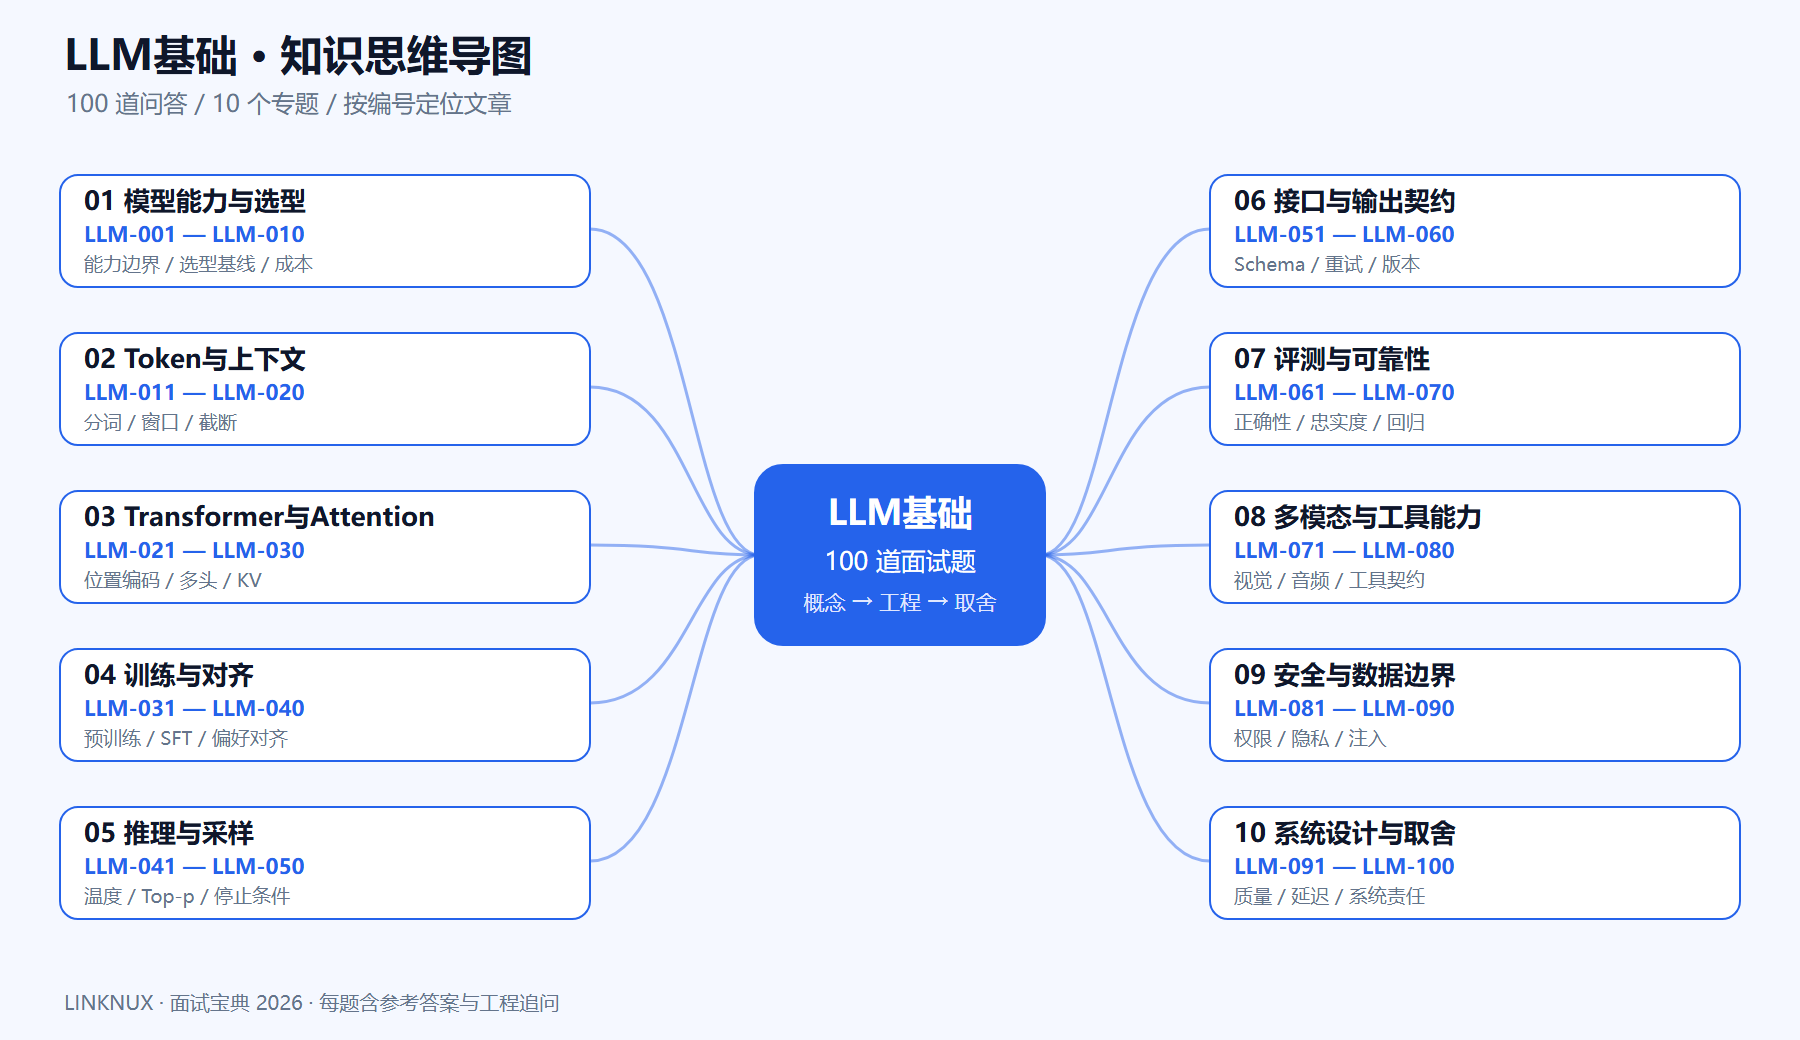
本篇目录
- LLM-021 Self-Attention 在做什么?
- LLM-022 Q、K、V 可以怎样直观解释?
- LLM-023 为什么点积注意力需要缩放?
- LLM-024 多头注意力有什么意义?
- LLM-025 位置编码解决什么问题?
- LLM-026 RoPE 的核心直觉是什么?
- LLM-027 残差连接与归一化有什么作用?
- LLM-028 FFN 与 Attention 如何分工?
- LLM-029 Encoder、Decoder 与 Encoder-Decoder 有何区别?
- LLM-030 MoE 为什么总参数大但激活参数较少?
LLM-021 Self-Attention 在做什么?
难度:中级
参考答案:它根据当前序列各位置的表示计算相关性,再汇聚其他位置的信息,形成上下文相关表示。应用面试重点是理解信息交互,而不是背公式;还要区分训练时可见的上下文与生成时的因果约束。
工程追问:为什么 decoder 不能查看未来 token?
LLM-022 Q、K、V 可以怎样直观解释?
难度:中级
参考答案:Q 表达当前位置要寻找什么,K 表达其他位置可被匹配的特征,V 承载最终聚合的信息。这是理解线性投影与相关性计算的比喻,三者都由模型学习,不是人为指定的数据库字段。
工程追问:Q 与 K 相似就一定代表事实相关吗?
LLM-023 为什么点积注意力需要缩放?
难度:中级
参考答案:维度较大时点积分布可能变得更宽,使 softmax 过于尖锐、梯度变差。缩放控制数值尺度,配合归一化和稳定实现;实际架构还可能使用其他注意力变体,不能把某个公式套用到所有模型。
工程追问:混合精度下如何避免数值溢出?
LLM-024 多头注意力有什么意义?
难度:中级
参考答案:多个头在不同投影空间学习信息关系,再组合结果,能够表达不同的依赖模式。但不能简单给每个头固定“语法头”或“知识头”的解释;头数更多也不必然改善具体任务效果。
工程追问:剪枝注意力头应如何评测?
LLM-025 位置编码解决什么问题?
难度:中级
参考答案:注意力本身不足以表达序列顺序,需要引入位置信息。绝对位置、相对位置与旋转位置等方法具有不同性质;应用侧应关注长度扩展、位置敏感任务和部署实现是否与训练一致。
工程追问:为什么随意扩展位置参数可能损害质量?
LLM-026 RoPE 的核心直觉是什么?
难度:中级
参考答案:它对查询和键的表示施加与位置相关的旋转,使相对位置关系影响注意力得分。它不是无限长度能力的保证;超出训练长度时仍需合适的扩展方法与长上下文评测。
工程追问:长窗口扩展应测哪些失败案例?
LLM-027 残差连接与归一化有什么作用?
难度:中级
参考答案:残差提供信息和梯度传播路径,归一化帮助稳定不同层的数值尺度。它们支持深层网络训练,但具体放置方式因架构而异;排查微调异常时要考虑精度、梯度和实现一致性。
工程追问:训练损失突然变成 NaN 怎样排查?
LLM-028 FFN 与 Attention 如何分工?
难度:中级
参考答案:Attention 主要跨位置混合信息,FFN 对各位置的表示进行非线性变换。二者共同构成层的表达能力;实际推理开销取决于模型维度、序列长度和实现,不能只优化注意力而忽略其他算子。
工程追问:短请求的计算瓶颈一定是注意力吗?
LLM-029 Encoder、Decoder 与 Encoder-Decoder 有何区别?
难度:中级
参考答案:Encoder 常用于双向表示,Decoder 常用于自回归生成,Encoder-Decoder 将输入编码与输出生成分开。选择架构要看检索表示、分类、翻译或生成任务,不能把所有 Transformer 都当成聊天模型。
工程追问:Embedding 模型通常需要哪些任务特性?
LLM-030 MoE 为什么总参数大但激活参数较少?
难度:中级
参考答案:MoE 通过路由选择部分专家参与一次计算,因此总容量和每 token 的激活计算量不同。它仍要承担权重存储、专家通信和负载均衡成本;容量规划不能只看激活参数量。
工程追问:专家并行为什么可能受网络带宽限制?
复盘练习
任选一题,用“场景与约束 → 方案 → 验证方法 → 失败边界”组织一段回答。初级先讲清概念,中级补实现与测试,高级补成本、权限和故障取舍。难度标签是学习建议,同一题可继续深入。
延伸阅读
以下为本模块相关原始论文与官方文档,用于继续学习;本文为原创面试要点整理,具体框架行为以所用版本为准。