
本篇 10 题|覆盖初级到高级|训练与对齐。先用自己的话回答,再核对参考要点,最后练习工程追问。
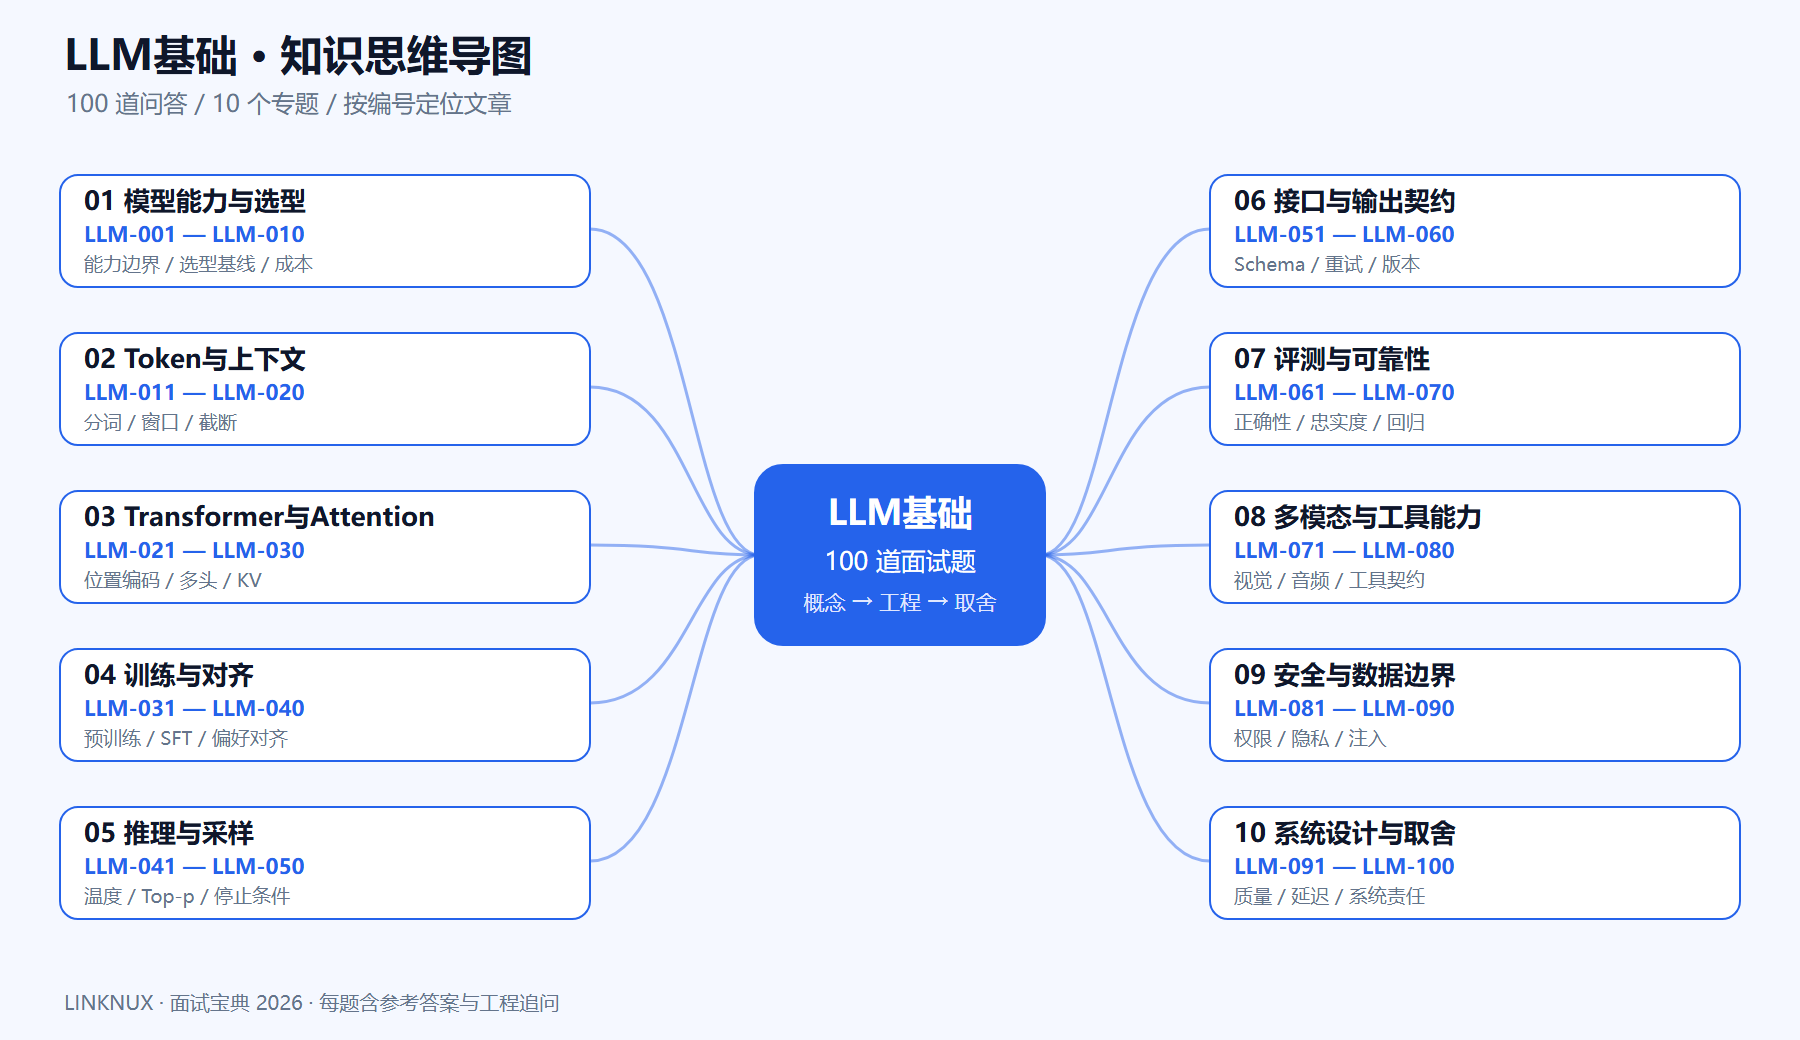
本篇目录
- LLM-031 自回归预训练的目标是什么?
- LLM-032 SFT 的作用是什么?
- LLM-033 RLHF 可以怎样解释?
- LLM-034 DPO 与基于奖励模型的优化有什么区别?
- LLM-035 为什么数据去重很重要?
- LLM-036 什么是灾难性遗忘?
- LLM-037 训练集、验证集、测试集如何划分?
- LLM-038 为什么格式正确的训练数据仍可能有问题?
- LLM-039 模型知识截止时间对应用意味着什么?
- LLM-040 为什么对齐后的模型也可能被诱导?
LLM-031 自回归预训练的目标是什么?
难度:中级
参考答案:给定前面的 token,预测下一个 token,通过大量样本学习语言和模式。训练目标提供统计学习信号,并不直接保证真实性、权限意识或业务成功;这些还需要数据、对齐和应用层约束。
工程追问:预测损失降低为什么不等于任务准确率提高?
LLM-032 SFT 的作用是什么?
难度:中级
参考答案:监督微调用输入与期望输出示例,教模型遵循特定任务、风格和格式。它能改变行为分布,但不能可靠替代及时更新的知识库;效果依赖数据质量、模板一致性和独立测试集。
工程追问:什么样的样本会让模型学会错误习惯?
LLM-033 RLHF 可以怎样解释?
难度:中级
参考答案:通常先获取人类偏好或相关反馈,再用奖励信号优化模型行为。它帮助输出符合偏好,但奖励模型也可能有偏差或被投机利用;应同时检查事实性、拒答边界与真实业务质量。
工程追问:“用户更喜欢”是否等于“答案更正确”?
LLM-034 DPO 与基于奖励模型的优化有什么区别?
难度:中级
参考答案:DPO 使用成对偏好数据直接优化模型相对参考策略的偏好目标,通常不需要单独跑在线强化学习回路。它仍依赖偏好标注质量和训练设定,不能保证比其他对齐方式在所有任务上更好。
工程追问:偏好数据中有长度偏差怎么办?
LLM-035 为什么数据去重很重要?
难度:中级
参考答案:重复样本会放大某些模式、影响有效数据量,并可能导致评测污染。去重应结合文本近重复、来源和任务结构,不能把合理的格式重复全部删除;需要记录保留规则和版本。
工程追问:训练集与测试集有哪些隐蔽的重复关系?
LLM-036 什么是灾难性遗忘?
难度:中级
参考答案:模型针对新任务更新后,原有能力可能下降。应混入必要的通用或旧任务样本,控制更新幅度,并用多任务回归集比较;只观察新任务训练损失无法发现遗忘。
工程追问:如何区分遗忘与测试分布变化?
LLM-037 训练集、验证集、测试集如何划分?
难度:中级
参考答案:按实际部署的时间、用户、文档或任务来源分组,尽量避免同源内容跨集合泄漏。验证集用于选择配置,测试集保留作最终检查;反复依据测试结果调参会降低其独立性。
工程追问:同一合同的不同切片应分到哪里?
LLM-038 为什么格式正确的训练数据仍可能有问题?
难度:中级
参考答案:格式校验只证明数据可读取,无法证明答案真实、角色边界正确或标注一致。还要抽查语义、重复、敏感信息、拒答和工具结果,并识别业务中不会出现的人工痕迹。
工程追问:如何设计低成本的数据质量抽检?
LLM-039 模型知识截止时间对应用意味着什么?
难度:中级
参考答案:截止时间描述训练知识可能覆盖的范围,不保证模型掌握截止前每个事实。实时价格、政策或业务状态必须查外部数据,并附来源和时间;不要用模型自述的截止时间作为唯一证据。
工程追问:回答“目前”类问题时应带哪些元数据?
LLM-040 为什么对齐后的模型也可能被诱导?
难度:中级
参考答案:模型仍会受到上下文、分布外输入和工具反馈的影响。应组合输入信任分层、服务端权限、受限工具和结果验证;对齐是模型能力的一部分,不能替代系统安全边界。
工程追问:如何阻止一次提示注入触发越权操作?
复盘练习
任选一题,用“场景与约束 → 方案 → 验证方法 → 失败边界”组织一段回答。初级先讲清概念,中级补实现与测试,高级补成本、权限和故障取舍。难度标签是学习建议,同一题可继续深入。
延伸阅读
以下为本模块相关原始论文与官方文档,用于继续学习;本文为原创面试要点整理,具体框架行为以所用版本为准。