
本篇 10 题|覆盖初级到高级|推理与采样。先用自己的话回答,再核对参考要点,最后练习工程追问。
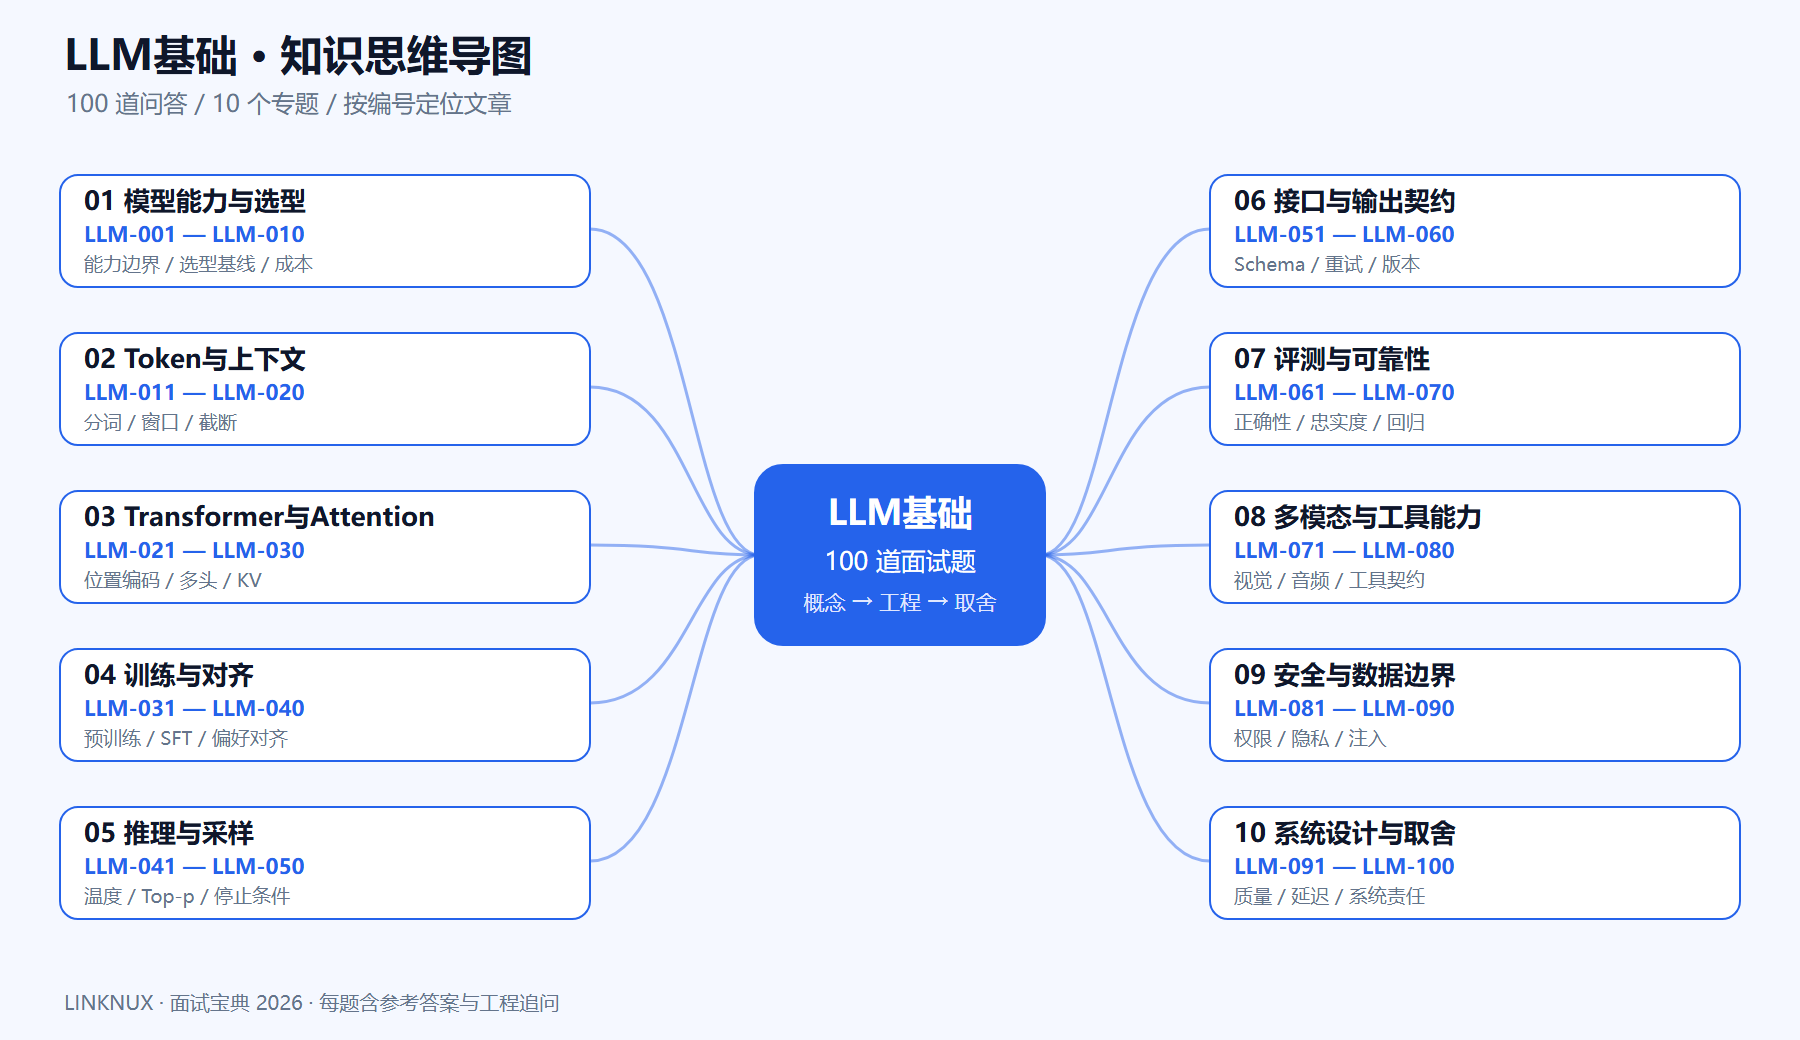
本篇目录
- LLM-041 Prefill 与 Decode 的区别是什么?
- LLM-042 temperature 会怎样影响生成?
- LLM-043 top-p 与 top-k 有何区别?
- LLM-044 贪心解码有什么优缺点?
- LLM-045 重复惩罚能解决哪些问题?
- LLM-046 max output tokens 设置过小会怎样?
- LLM-047 停止序列应该如何设计?
- LLM-048 随机种子能保证跨环境复现吗?
- LLM-049 为什么更多推理预算不一定更好?
- LLM-050 如何评价流式响应的用户体验?
LLM-041 Prefill 与 Decode 的区别是什么?
难度:中级
参考答案:Prefill 处理已有输入并建立上下文缓存,Decode 逐步生成新 token。长输入通常增加首 token 等待,长输出增加持续生成时间;应分别测量两阶段,才能解释用户感受到的慢。
工程追问:首 token 慢与每 token 慢如何分别优化?
LLM-042 temperature 会怎样影响生成?
难度:中级
参考答案:temperature 调整采样分布的集中程度,较低值通常更集中,较高值通常更随机。它不能修复知识缺失或逻辑错误,也不等于可信度;应针对任务评测质量和输出稳定性。
工程追问:为什么设为零仍不能保证所有服务完全复现?
LLM-043 top-p 与 top-k 有何区别?
难度:中级
参考答案:top-k 保留固定数量的候选,top-p 保留累积概率达到阈值的候选集合。它们限制采样范围,可能与 temperature 联合作用;不同服务的支持和实现需核对,不能机械照抄同一参数组合。
工程追问:结构化抽取任务应怎样选择采样设置?
LLM-044 贪心解码有什么优缺点?
难度:中级
参考答案:每一步选概率最高的 token,实现简单且输出较集中,但局部选择不保证最终任务最优。应用应判断是否需要多样性和多候选验证,不应把贪心输出视为经过证明的正确答案。
工程追问:何时需要生成多个候选再评分?
LLM-045 重复惩罚能解决哪些问题?
难度:中级
参考答案:它可降低某些重复模式,但也可能影响必须重复的名称、字段或代码。应先排查模板、终止符与训练偏差,再在业务集上调整惩罚;长重复循环不一定只由采样参数造成。
工程追问:抽取多个同名字段时如何避免误伤?
LLM-046 max output tokens 设置过小会怎样?
难度:中级
参考答案:输出可能在句子、JSON 或工具参数中途被截断。客户端要识别长度终止原因并避免执行不完整结果;预算应按任务难度和输出 schema 估算,而不是统一设置一个很小的固定值。
工程追问:截断 JSON 应重试还是局部修补?
LLM-047 停止序列应该如何设计?
难度:中级
参考答案:停止序列用于识别生成边界,但可能与正常内容冲突。应优先使用模型和接口支持的标准终止方式,再对代码、表格和特殊符号测试;不要用常见换行或短词随意截断所有任务。
工程追问:多段代码输出为什么容易被错误截断?
LLM-048 随机种子能保证跨环境复现吗?
难度:中级
参考答案:通常只能提高特定条件下的可重复性,硬件、算子、服务调度和模型版本仍可能改变结果。要记录完整配置与版本,并对业务指标做统计比较,不能仅凭 seed 宣称结果绝对一致。
工程追问:云服务只暴露 seed 时还应记录什么?
LLM-049 为什么更多推理预算不一定更好?
难度:中级
参考答案:复杂任务可能受益于额外计算,但也可能增加延迟、重复尝试或偏离证据。应按任务分层比较收益,并设预算上限与停止条件;不能用答案长度作为推理质量的替代指标。
工程追问:怎样测量额外推理带来的边际收益?
LLM-050 如何评价流式响应的用户体验?
难度:中级
参考答案:同时看首 token、token 间隔、完成时间、取消响应和错误提示。流式传输改善感知速度,却不自动减少总耗时;服务端还需处理断连、背压和计费边界,避免用户看到残缺成功。
工程追问:网络断开后怎样判断任务是否仍在运行?
复盘练习
任选一题,用“场景与约束 → 方案 → 验证方法 → 失败边界”组织一段回答。初级先讲清概念,中级补实现与测试,高级补成本、权限和故障取舍。难度标签是学习建议,同一题可继续深入。
延伸阅读
以下为本模块相关原始论文与官方文档,用于继续学习;本文为原创面试要点整理,具体框架行为以所用版本为准。