
本篇 10 题|覆盖初级到高级|评测与可靠性。先用自己的话回答,再核对参考要点,最后练习工程追问。
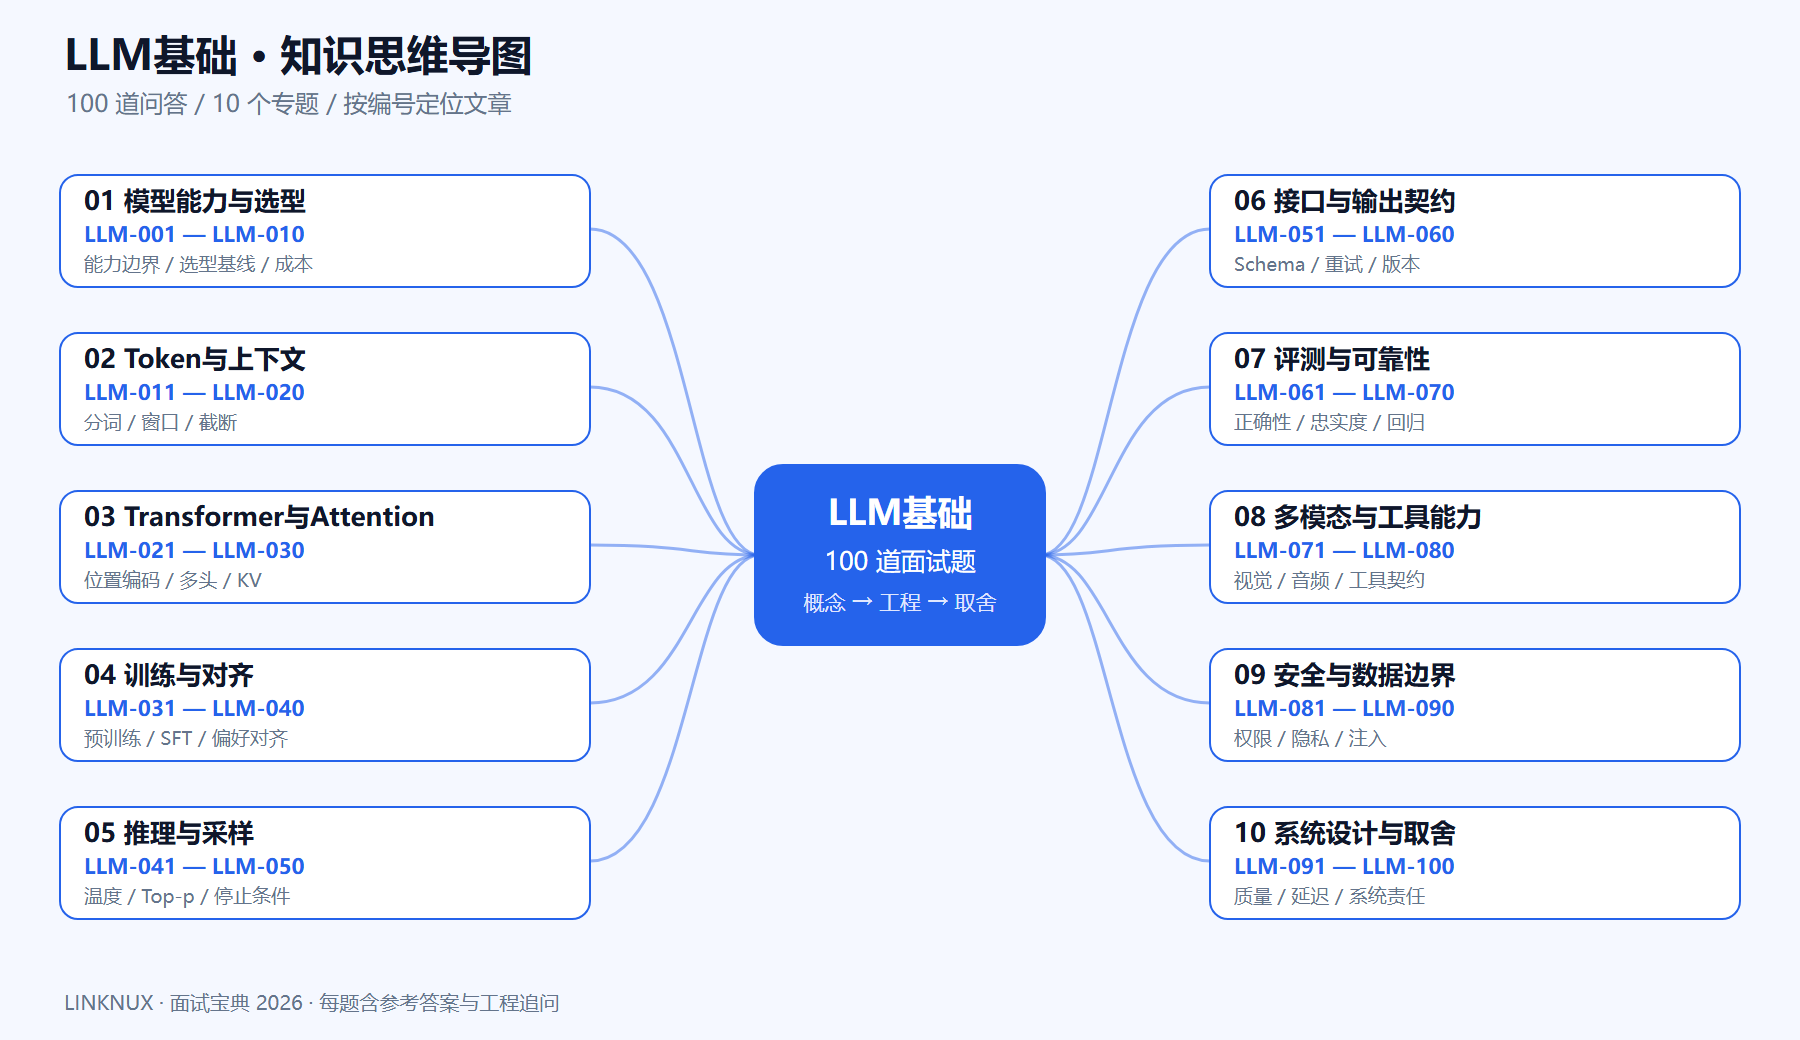
本篇目录
- LLM-061 为什么不能只用通用排行榜选模型?
- LLM-062 什么是离线评测与在线评测?
- LLM-063 如何用 LLM 作为评审模型?
- LLM-064 为什么要做成对比较?
- LLM-065 正确率与用户满意度为什么不同?
- LLM-066 模型置信度是否可信?
- LLM-067 如何评测拒答能力?
- LLM-068 回归测试集如何维护?
- LLM-069 怎么报告一次模型对比实验?
- LLM-070 为什么模型更新必须做灰度?
LLM-061 为什么不能只用通用排行榜选模型?
难度:中级
参考答案:通用榜单的任务、提示和数据分布可能与业务不同,也可能存在污染或评分偏差。应建立代表性业务集,分别评估正确性、约束遵循、成本和时延,再用榜单作初筛参考。
工程追问:业务测试集应覆盖哪些长尾场景?
LLM-062 什么是离线评测与在线评测?
难度:中级
参考答案:离线评测在固定样本上可重复比较,在线评测反映真实请求与用户反馈。两者需要结合:离线先做回归门禁,在线再观察分层指标、投诉与失败案例,防止平均值掩盖关键风险。
工程追问:离线提升但在线变差可能有哪些原因?
LLM-063 如何用 LLM 作为评审模型?
难度:中级
参考答案:先定义清晰评分标准与对比方式,再用人工标注样本校准评审一致性。评审模型存在位置、长度和风格偏差,需盲测、交换候选顺序和抽样复核;它不能自动成为事实裁判。
工程追问:评审模型与被测模型相同时会怎样?
LLM-064 为什么要做成对比较?
难度:中级
参考答案:同一输入下比较两个方案,能降低样本难度差异带来的噪声。应隐藏方案身份、随机展示顺序,并报告胜负及不确定性;不能只挑选几个展示效果好的例子说明整体提升。
工程追问:大量平局时如何解释结果?
LLM-065 正确率与用户满意度为什么不同?
难度:中级
参考答案:满意度受表达、速度和任务完成感影响,正确率关注事实或目标是否满足。应分别测量并分析矛盾样本,避免优化流畅度后掩盖错误,或为了严谨让产品无法完成实际任务。
工程追问:如何处理“用户喜欢但事实错误”的回答?
LLM-066 模型置信度是否可信?
难度:中级
参考答案:模型自述的“很确定”不是经过校准的概率。可以结合证据覆盖、检索分数、校验结果和历史表现构建风险分层,但需要独立评测;高风险输出仍应有人工或确定性验证。
工程追问:如何选择自动通过与人工复核的阈值?
LLM-067 如何评测拒答能力?
难度:中级
参考答案:同时测试应拒答与不应拒答的样本,衡量漏拒和过度拒答,并按业务类型分层。拒答要说明缺失条件或提供可行下一步,不能把一律拒答包装成更安全、更准确的系统。
工程追问:知识缺失与权限不足的提示应怎样不同?
LLM-068 回归测试集如何维护?
难度:中级
参考答案:保留稳定基准与已修复故障案例,同时定期加入新分布样本,记录来源、标签和版本。应控制测试泄漏,避免训练或调提示直接迎合所有测试题,导致线上泛化能力被高估。
工程追问:线上事故怎样转成一条有价值的回归用例?
LLM-069 怎么报告一次模型对比实验?
难度:中级
参考答案:说明数据范围、任务分层、提示版本、采样设置和失败样本,给出质量、成本、延迟及误差范围。随机生成任务需要多次运行;只报一个均值或单次截图不能支持稳定结论。
工程追问:样本量不足时应如何表达结论?
LLM-070 为什么模型更新必须做灰度?
难度:高级
参考答案:更新可能改变输出模式、拒答、工具行为与延迟。先在影子流量或小比例请求中观察,再逐步扩大,同时保留旧版本和配置回退;数据库或业务写入不能仅靠模型版本回退恢复。
工程追问:什么指标触发暂停灰度?
复盘练习
任选一题,用“场景与约束 → 方案 → 验证方法 → 失败边界”组织一段回答。初级先讲清概念,中级补实现与测试,高级补成本、权限和故障取舍。难度标签是学习建议,同一题可继续深入。
延伸阅读
以下为本模块相关原始论文与官方文档,用于继续学习;本文为原创面试要点整理,具体框架行为以所用版本为准。