
本篇 10 题|覆盖初级到高级|多模态与工具能力。先用自己的话回答,再核对参考要点,最后练习工程追问。
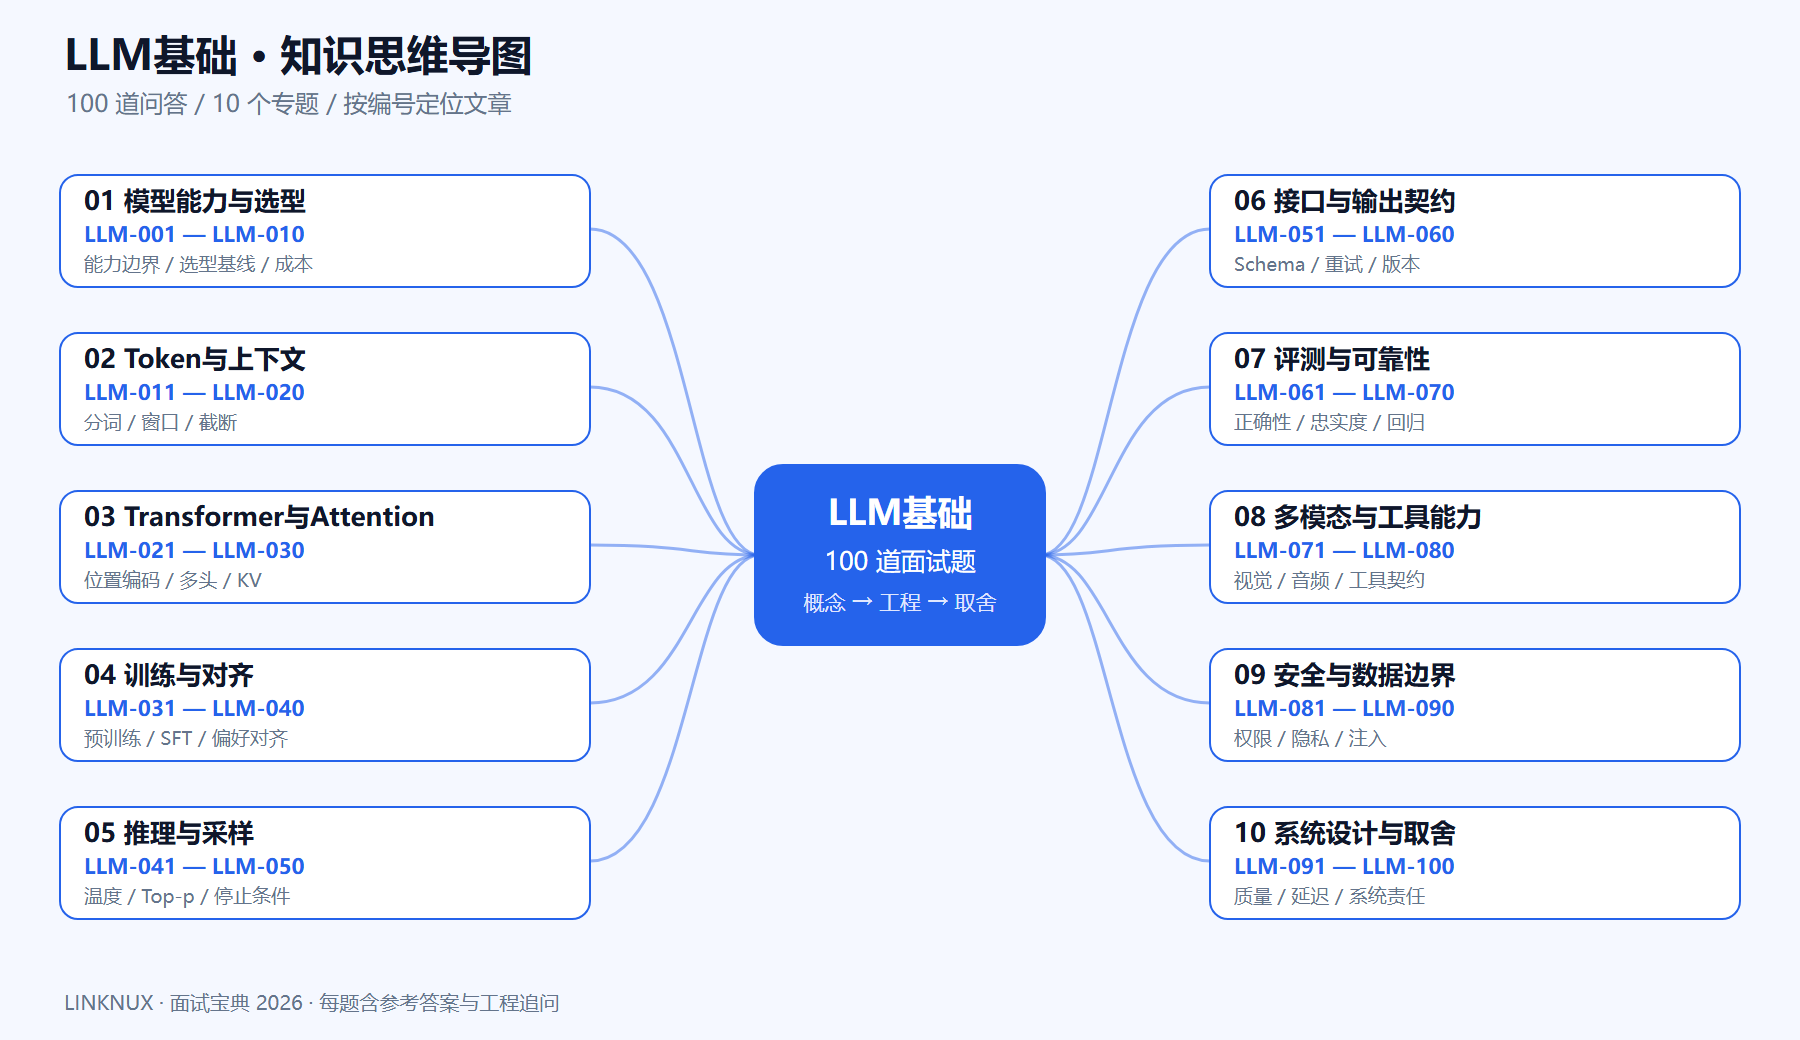
本篇目录
- LLM-071 多模态模型能否直接理解任意图片?
- LLM-072 OCR 与视觉语言模型如何协作?
- LLM-073 音频应用需要关注哪些额外问题?
- LLM-074 视频输入为什么不能只看单帧?
- LLM-075 Embedding 模型与生成模型有什么区别?
- LLM-076 模型会调用工具是否意味着适合 Agent?
- LLM-077 结构化输入为何有利于工具使用?
- LLM-078 如何评测代码生成能力?
- LLM-079 大模型与搜索引擎的关系是什么?
- LLM-080 为什么模型工具能力要单独评测?
LLM-071 多模态模型能否直接理解任意图片?
难度:中级
参考答案:能力受分辨率、缩放、图像质量和训练分布影响。表格、细小文字与专业图像需要专项评测,必要时结合 OCR 或专用工具;不能把一般图像问答能力等同于精确视觉测量。
工程追问:低分辨率截图应先怎样处理?
LLM-072 OCR 与视觉语言模型如何协作?
难度:中级
参考答案:OCR 提供可定位的文本与版面信息,视觉模型补充图形和上下文理解。对需要精确引用的场景,应保留页码、框位置和原图,使用一致性校验,避免视觉描述代替可核实的文字证据。
工程追问:表格数字识别错一位怎样发现?
LLM-073 音频应用需要关注哪些额外问题?
难度:中级
参考答案:语音识别、说话人分离、停顿、口音与背景噪声都会影响后续模型判断。应保留时间戳和置信线索,对关键实体复核;端到端语音体验还要考虑中断、回声和流式延迟。
工程追问:同音词导致订单对象错误如何处理?
LLM-074 视频输入为什么不能只看单帧?
难度:中级
参考答案:单帧可能遗漏时序、动作和因果关系。应按任务选择采样频率或事件切片,保留时间关联与原始证据,并评测短暂事件的漏检;更密集采样也会增加成本和上下文占用。
工程追问:如何发现只出现半秒的关键事件?
LLM-075 Embedding 模型与生成模型有什么区别?
难度:中级
参考答案:Embedding 模型把输入映射为便于相似度计算的表示,生成模型输出内容。两者目标和接口不同,生成能力强不代表检索表示好;Embedding 选型应针对语言、领域和检索指标评测。
工程追问:为什么不能直接比较不同模型的向量?
LLM-076 模型会调用工具是否意味着适合 Agent?
难度:中级
参考答案:工具选择只是一个环节,Agent 还需要状态、停止、权限和错误恢复。应评测连续多步任务及副作用控制,不能凭一次正确调用就判断它能可靠完成长流程。
工程追问:十步任务每步九成成功时整体如何估算?
LLM-077 结构化输入为何有利于工具使用?
难度:中级
参考答案:明确字段与单位减少歧义,使模型和校验器更容易发现缺项。工具 schema 应描述业务含义、必填条件与取值约束,但真实权限、资源存在性和副作用仍由执行服务验证。
工程追问:“金额”字段应怎样约定币种与精度?
LLM-078 如何评测代码生成能力?
难度:中级
参考答案:运行编译、单元测试和必要的集成检查,再观察安全性、可维护性及需求覆盖。模型生成的测试也可能重复其错误假设,需要独立测试和人工审查;不能只凭代码看起来合理就上线。
工程追问:如何检查生成代码是否偷偷增加了外部依赖?
LLM-079 大模型与搜索引擎的关系是什么?
难度:中级
参考答案:搜索负责发现信息,模型负责理解、筛选与表达,二者可以组成带来源的回答流程。搜索结果的排名和摘要也不自动可靠,应核对原始出处、时间和冲突证据。
工程追问:如何避免模型引用搜索摘要中不存在的结论?
LLM-080 为什么模型工具能力要单独评测?
难度:中级
参考答案:自然语言答题好不代表参数正确或执行安全。工具评测应包括名称选择、必填项、单位、权限、失败恢复与并行依赖,并记录实际任务成功,而不只统计调用格式正确率。
工程追问:工具调用格式全对但任务失败会有哪些原因?
复盘练习
任选一题,用“场景与约束 → 方案 → 验证方法 → 失败边界”组织一段回答。初级先讲清概念,中级补实现与测试,高级补成本、权限和故障取舍。难度标签是学习建议,同一题可继续深入。
延伸阅读
以下为本模块相关原始论文与官方文档,用于继续学习;本文为原创面试要点整理,具体框架行为以所用版本为准。